
Les LLM tabulaires sont là : des avancées majeures pour les équipes risque

Les progrès du deep learning ont permis des avancées majeures dans presque tous les secteurs, de la mobilité (Waymo) et la biologie (AlphaFold) à la musique (Suno.ai). Pourtant, malgré le succès du deep learning sur des tâches très complexes comme la conduite autonome, les applications liées au risque sont restées étonnamment absentes de cette révolution. Mais cela est sur le point de changer.
Si les équipes risque n'ont pas encore intégré les réseaux de neurones profonds à leur boîte à outils, c'est notamment à cause de leurs difficultés historiques avec les données tabulaires. Les banques, les fintechs et les compagnies d'assurance regorgent de données tabulaires et les utilisent au quotidien pour prévenir la fraude, détecter le blanchiment d'argent et évaluer le risque de crédit. Et pour construire des modèles de prédiction très précis dans ces cas d'usage, la famille des modèles d'arbres à gradient boosté règne en maître.
Le « moment ChatGPT » des données tabulaires
Lors d'un lancement que les acteurs du secteur ont qualifié de « moment ChatGPT » des données tabulaires, Prior Labs a publié un modèle révolutionnaire : TabPFN. Ce modèle surpasse largement les méthodes existantes sur les jeux de données tabulaires, pour un large éventail de tâches tabulaires, un résultat si important qu'il a récemment été publié dans Nature.
Compte tenu du large éventail d'applications à forte valeur dans les services financiers, nous sommes enthousiastes à l'idée de nous associer à Prior Labs pour donner aux équipes risque, fraude et conformité l'accès à TabPFN.
Points clés
- Prior Labs a publié un modèle révolutionnaire, TabPFN, qui surpasse largement les méthodes existantes sur les jeux de données tabulaires, pour un éventail de tâches tabulaires.
- Ce modèle est le nouvel état de l'art pour les petits volumes de données, et les équipes n'ont pas besoin d'une infrastructure complexe de réentraînement et de MLOps.
- Nous nous sommes associés à Prior Labs pour rendre TabPFN accessible sur la plateforme Taktile, pour des applications de gestion du risque et d'optimisation des décisions.
- Le modèle prouve déjà sa valeur dans plusieurs applications de risque, comme les contrôles anti-fraude et la détection d'anomalies dans le risque de crédit.
Comment fonctionne TabPFN
Contrairement aux tentatives précédentes de rendre les réseaux de neurones profonds utiles pour les données tabulaires, ce modèle est pré-entraîné. Tout comme les LLM modernes sont pré-entraînés sur un vaste corpus de textes, dont l'essentiel de l'internet public, TabPFN a été pré-entraîné sur un large éventail de jeux de données synthétiques, une innovation clé du modèle.
Quand vous faites une prédiction avec TabPFN, vous lui fournissez un certain nombre de lignes étiquetées de vos données, en plus de lignes non étiquetées. Il complète ensuite les lignes non étiquetées avec des prédictions, un peu comme un LLM s'appuie sur les exemples d'un prompt pour répondre à votre requête.
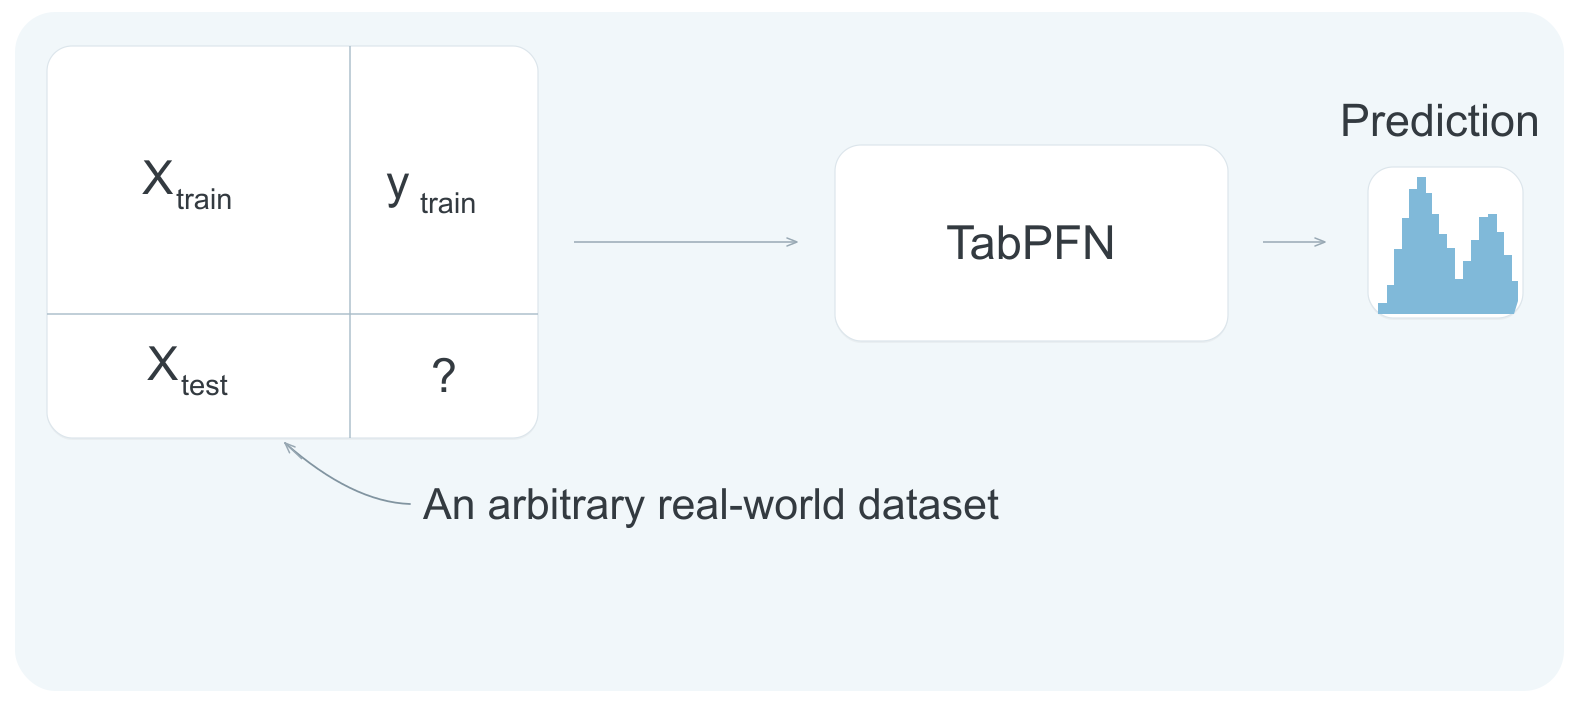
Cela peut sembler incroyable à première vue : il n'y a aucun entraînement du modèle au sens traditionnel du terme. Les paramètres (poids) du modèle restent fixes tout du long. Le modèle s'appuie plutôt sur la flexibilité et la puissance de l'architecture transformer pour apprendre les motifs de vos données pendant qu'il exécute la prédiction. Le fait que cela fonctionne aussi bien était d'ailleurs surprenant aux débuts de la modélisation du langage.
L'intérêt de TabPFN pour les professionnels du risque
Comme le modèle n'est pas entraîné pour chaque nouveau cas d'usage et s'appuie fortement sur ses connaissances a priori issues du pré-entraînement, il offre plusieurs avantages clés aux professionnels des services financiers :
- Les experts métier peuvent désormais produire des prédictions de modèle compétitives sans des années d'expérience en data science, ce qui permet des équipes plus petites, plus rapides et plus autonomes.
- Le modèle est performant sur les petits volumes de données, ce qui est particulièrement intéressant pour la fraude, le crédit et la lutte contre le blanchiment d'argent, car de nombreuses entreprises ont relativement peu de vrais positifs.
- Les équipes n'ont pas besoin d'une infrastructure complexe de réentraînement et de MLOps : sans réentraînement, vous réduisez au minimum la charge liée à la validation, aux tests et à l'approbation du modèle.
TabPFN offre aussi de précieuses fonctionnalités supplémentaires, souvent source de frictions en machine learning :
- Le modèle renvoie naturellement des distributions pour ses résultats, que vous pouvez exploiter dans vos décisions en aval.
- Le modèle gère nativement les valeurs manquantes et les valeurs aberrantes : inutile de réfléchir à l'imputation ou à d'autres stratégies pour mettre vos données au format attendu par votre modèle.
- Le modèle peut fournir des explications de ses prédictions (grâce aux valeurs de Shapley), ce qui atténue les craintes liées à l'IA « boîte noire ».
"Nous sommes extrêmement enthousiastes quant à la capacité de TabPFN à transformer la façon dont les équipes utilisent le deep learning pour concevoir et optimiser des produits financiers. Les cas d'usage que nous voyons avec Taktile ne sont vraiment que le début de ce qui est possible."
Applications concrètes de TabPFN dans les cas d'usage de risque
1. Contrôles anti-fraude
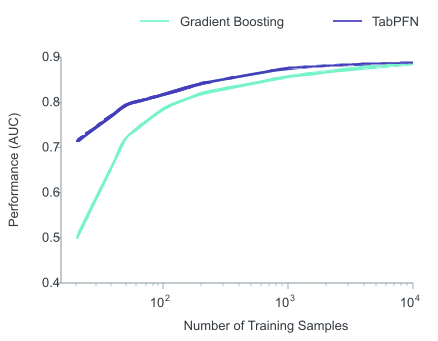
Comme le modèle est performant sur les petits volumes de données, nous pensons que l'application immédiate la plus prometteuse est le contrôle anti-fraude. Nous avons évalué les performances du modèle sur un jeu de données anonymisé de fraude à l'ouverture de compte, issu du monde réel, et les avons comparées à une approche standard par arbres boostés. Plus les données sont rares, plus l'avantage du modèle sur l'approche classique de machine learning est grand. Remarquez à quel point le modèle s'en sort étonnamment bien quand il voit à peine des données d'entraînement : c'est la puissance du pré-entraînement à l'œuvre.
Exemple : détection de la fraude à l'ouverture de compte
2. Détection d'anomalies dans le risque de crédit
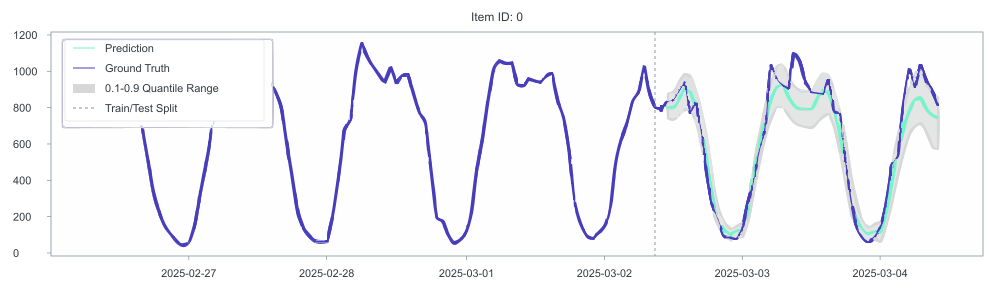
La détection d'anomalies est une autre application qui nous passionne. Le modèle se classe n° 1 sur les séries temporelles, surpassant même Chronos d'Amazon. Il peut donc aussi servir à prévoir les taux d'approbation et des indicateurs clés, comme le nombre de demandes ou la distribution des scores FICO des demandeurs. Si les indicateurs observés s'écartent trop de ces distributions, vous pouvez déclencher une alerte pour que les analystes enquêtent sur l'anomalie.
Exemple : détection d'anomalies sur les demandes de prêt quotidiennes
Ce ne sont là que deux exemples de ce qui nous enthousiasme dans TabPFN : nous croyons qu'il existe d'innombrables autres cas d'usage de valeur.
Il reste important de tenir compte des limites. Aujourd'hui, le délai de prédiction (latence d'inférence) est relativement élevé et la taille des données prises en charge est limitée. Nous nous attendons toutefois à ce que ces deux limites s'atténuent rapidement au cours de 2025.