
Os LLMs tabulares chegaram — e trazem avanços para equipes de risco

O avanço do deep learning impulsionou grandes descobertas em quase todos os setores — da mobilidade (Waymo) e da biologia (AlphaFold) à música (Suno.ai). No entanto, apesar do sucesso do deep learning em tarefas altamente complexas, como carros autônomos, as aplicações de risco ficaram visivelmente de fora dessa revolução. Mas isso está prestes a mudar.
Um dos principais motivos pelos quais as equipes de risco ainda não incorporaram redes neurais profundas ao seu conjunto de ferramentas é a dificuldade histórica dessas redes com dados tabulares. Bancos, fintechs e seguradoras têm dados tabulares em abundância e os usam diariamente para prevenir fraudes, detectar lavagem de dinheiro e determinar o risco de crédito. E, na hora de construir modelos de previsão altamente precisos para esses casos de uso, a família de modelos de árvores com gradient boosting reina absoluta.
O “momento ChatGPT” dos dados tabulares
Em um lançamento que os pares do setor apelidaram de “momento ChatGPT” dos dados tabulares, a Prior Labs lançou um modelo inovador: o TabPFN. Esse modelo supera de forma ampla os métodos existentes em conjuntos de dados tabulares, em uma grande variedade de tarefas tabulares — um resultado tão relevante que foi recentemente publicado na Nature.
Dada a ampla gama de aplicações de alto valor em serviços financeiros, estamos animados com a parceria com a Prior Labs para dar às equipes de risco, fraude e compliance acesso ao TabPFN.
Principais conclusões
- A Prior Labs lançou um modelo inovador, o TabPFN, que supera de forma ampla os métodos existentes em conjuntos de dados tabulares, em diversas tarefas tabulares.
- O modelo é o novo estado da arte em cenários com poucos dados, e as equipes não precisam de retreinamento complexo nem de infraestrutura de MLOps.
- Nos unimos à Prior Labs para tornar o TabPFN acessível na plataforma da Taktile, para aplicações em gestão de risco e otimização de decisões.
- O modelo já está se mostrando valioso em várias aplicações de risco, como verificações de fraude e detecção de anomalias em risco de crédito.
Como o TabPFN funciona
Ao contrário das tentativas anteriores de tornar redes neurais profundas úteis em contextos tabulares, o modelo é pré-treinado. Assim como os LLMs modernos são pré-treinados em um grande corpus de dados de texto, incluindo boa parte da internet pública, o TabPFN foi pré-treinado em uma ampla variedade de conjuntos de dados sintéticos – uma inovação central do modelo.
Quando você faz uma previsão com o TabPFN, fornece a ele um conjunto de linhas rotuladas dos seus dados, além de linhas sem rótulo. Ele então completa as linhas sem rótulo com previsões, de forma semelhante a como um LLM usa os exemplos de um prompt para ajudar você com uma consulta.
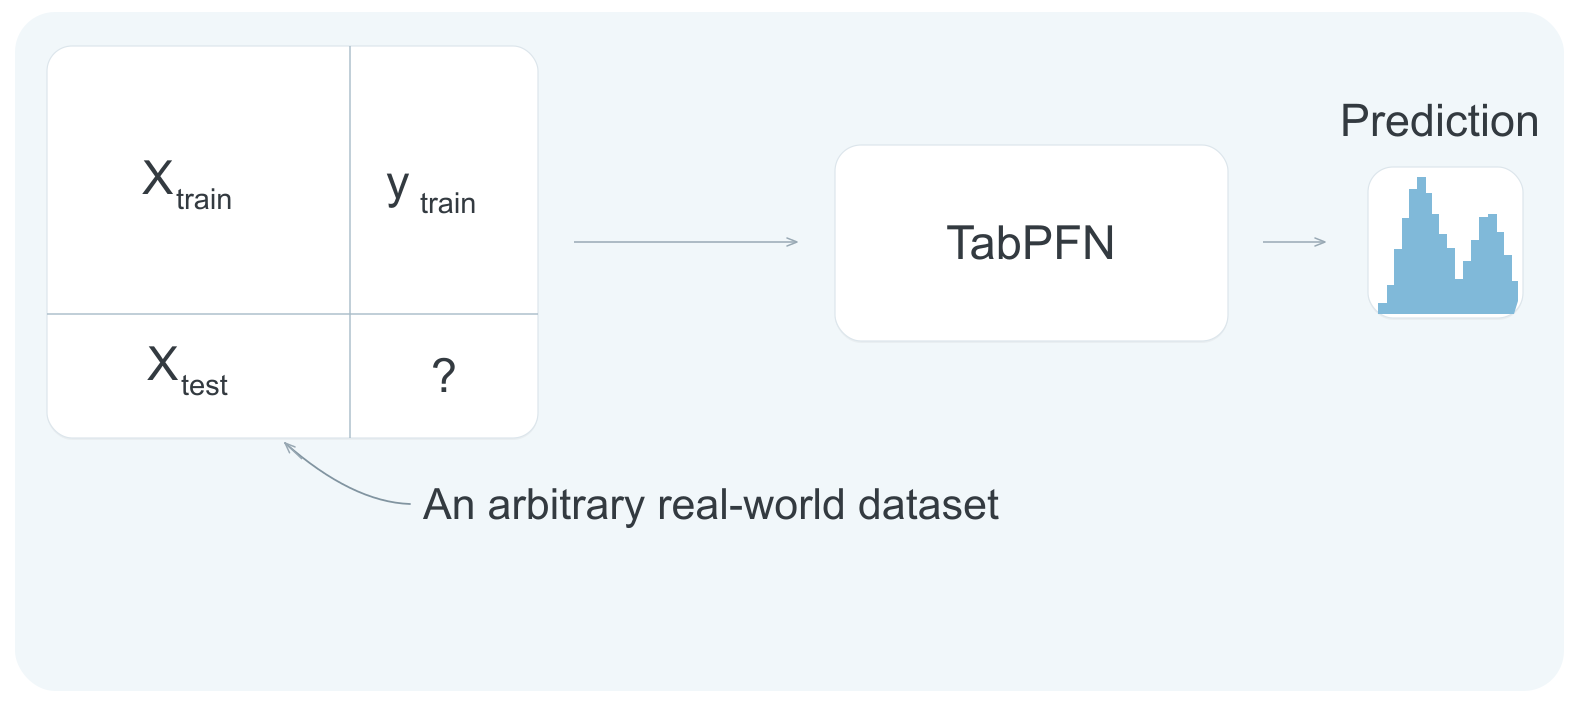
Ao ouvir isso pela primeira vez, pode parecer inacreditável que não exista treinamento de modelo no sentido tradicional da palavra. Os parâmetros (pesos) do modelo permanecem fixos o tempo todo. Em vez disso, o modelo se apoia na flexibilidade e no poder da arquitetura transformer para aprender os padrões dos seus dados enquanto executa a previsão. O fato de isso funcionar tão bem também foi surpreendente nos primórdios da modelagem de linguagem.
O valor do TabPFN para profissionais de risco
Como o modelo não é treinado a cada novo caso de uso e se apoia fortemente em seus priors do pré-treinamento, há algumas vantagens importantes para profissionais de serviços financeiros:
- Especialistas de domínio agora podem criar previsões de modelo competitivas sem precisar de anos de experiência em ciência de dados — isso significa equipes menores, mais rápidas e com mais autonomia.
- O modelo se sai bem em cenários com poucos dados — o que é particularmente interessante para aplicações de fraude, crédito e prevenção à lavagem de dinheiro, já que muitas empresas têm relativamente poucos verdadeiros positivos.
- As equipes não precisam de retreinamento complexo nem de infraestrutura de MLOps — sem retreinamento, é possível minimizar o esforço de validação, testes e aprovação do modelo.
O TabPFN também traz recursos adicionais valiosos, que costumam ser fonte de atrito em machine learning:
- O modelo retorna naturalmente distribuições para os seus resultados, que você pode usar em decisões posteriores.
- O modelo lida nativamente com valores ausentes e outliers, então você não precisa pensar em imputação nem em outras estratégias para ajustar os dados ao formato que o seu modelo espera.
- O modelo pode retornar explicações para suas previsões (usando os chamados Shapley Values), reduzindo as preocupações com IA de caixa-preta.
"Estamos muito animados com a capacidade do TabPFN de transformar a forma como as equipes trabalham com deep learning para construir e otimizar produtos financeiros. Os casos de uso que estamos vendo com a Taktile são apenas o começo do que é possível."
Aplicações reais do TabPFN em casos de uso de risco
1. Verificações de fraude
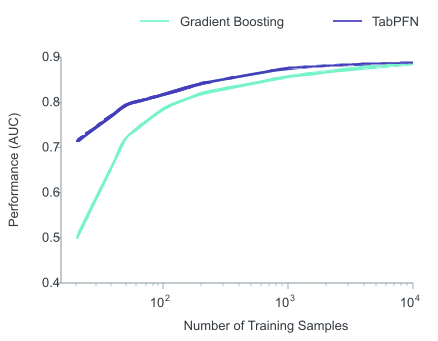
Como o modelo tem bom desempenho em cenários com poucos dados, acreditamos que a aplicação imediata mais interessante são as verificações de fraude. Fizemos o benchmark do desempenho do modelo em um conjunto de dados anonimizado e real de fraude na abertura de contas e o comparamos com uma abordagem padrão de árvores com boosting. Quanto mais esparsos ficam os dados, maior é a vantagem do modelo sobre a abordagem clássica de machine learning. Repare como o modelo se sai surpreendentemente bem quando mal vê dados de treinamento — esse é o poder do pré-treinamento em ação.
Exemplo: detecção de fraude na abertura de contas
2. Detecção de anomalias em risco de crédito
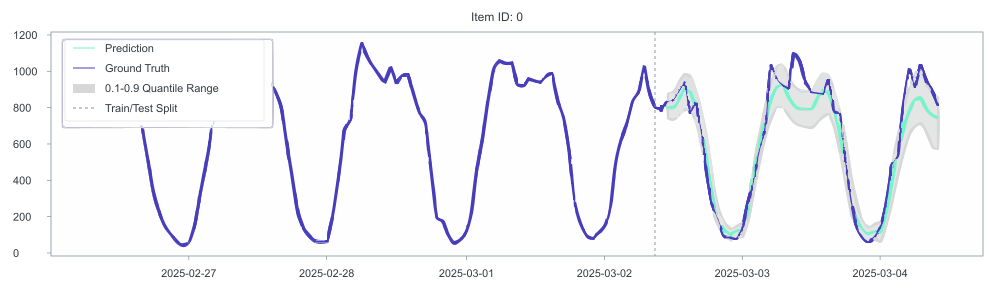
Outra aplicação pela qual somos apaixonados é a detecção de anomalias. O modelo ocupa o 1º lugar em séries temporais, superando até o Chronos da Amazon, e por isso também pode ser usado para prever taxas de aprovação e métricas-chave, como o número de solicitações ou a distribuição dos scores FICO dos solicitantes. Se as métricas observadas se afastarem demais dessas distribuições, você pode disparar um alerta para que os analistas investiguem a anomalia.
Exemplo: detecção de anomalias em solicitações diárias de empréstimo
São apenas dois exemplos de por que estamos tão animados com o TabPFN – acreditamos que existam inúmeros outros casos de uso valiosos.
É importante considerar as limitações. Hoje, o tempo até a previsão (latência de inferência) é relativamente alto e há limites para o tamanho de dados suportado. No entanto, esperamos que as duas limitações diminuam rapidamente ao longo de 2025.