
Le property-based testing avec Claude


Dan Luu a écrit un excellent article de blog, Dans quelle mesure les agents utilisent-ils les techniques de test et de vérification ?. Il en concluait que les consignes d’utiliser une technique précise n’aidaient pas beaucoup, mais que le property-based testing avait peut-être une faible valeur. Cet article portait sur les modèles d’OpenAI (Codex avec GPT-5.6 Sol) ; je voulais donc voir si le résultat se transposait aux modèles d’Anthropic. Cela a donné lieu à une analyse approfondie des performances des modèles et à une découverte personnelle saisissante sur le niveau réel de la dernière génération de modèles. Haiku 5.5 est désormais un bon modèle de codage agentique !
Le protocole du benchmark
Demandez à un modèle d’écrire en Rust un compresseur et un décompresseur Zstd, à partir de la seule spécification du format. Comparez trois conditions : aucune consigne de test, « Use property-based testing. », et le guide d’Anthropic sur le property-based testing. Le guide d’Anthropic est un ensemble de 13 Ko d’instructions détaillées, la hypo.md commande issue des travaux d’Anthropic sur le property-based testing agentique, portée de Hypothesis vers proptest en Rust. Sans accès à internet et sans véritable oracle zstd.
Résultat 1 : même Haiku est bon désormais
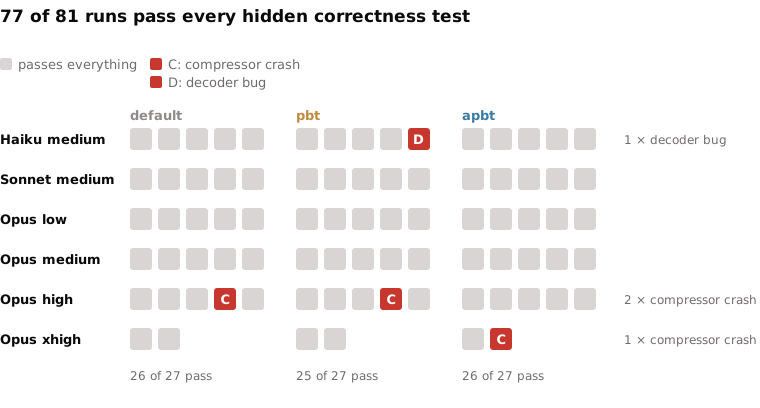
Tous les modèles réussissent cette tâche. La justesse fonctionnelle a été testée avec des suites cachées construites à partir du zstd de référence : 47 cas pour le décodeur, 17 cas pour le compresseur, 400 trames issues du générateur decodecorpus de zstd lui-même et 300 entrées de compresseur générées par fuzzing. Quelques exécutions ont échoué (4 sur 81), sans tendance nette selon le modèle ou la méthodologie de test. Les échecs relevaient de cas limites plutôt que d’une logique centrale défaillante : trois compresseurs ont planté lorsqu’un bloc entier de 128 Kio ne pouvait pas être compressé, et un décodeur a rejeté des trames valides.
Résultat 2 : le property-based testing produit des tests plus robustes aux niveaux inférieurs
Comme la justesse fonctionnelle ne départageait pas les modèles, nous avons mesuré la qualité des tests générés par mutation testing : les tests parvenaient-ils à détecter des bugs injectés ensuite dans le code ? C’est ici qu’apparaît un premier signal sur la qualité d’ingénierie des tests.
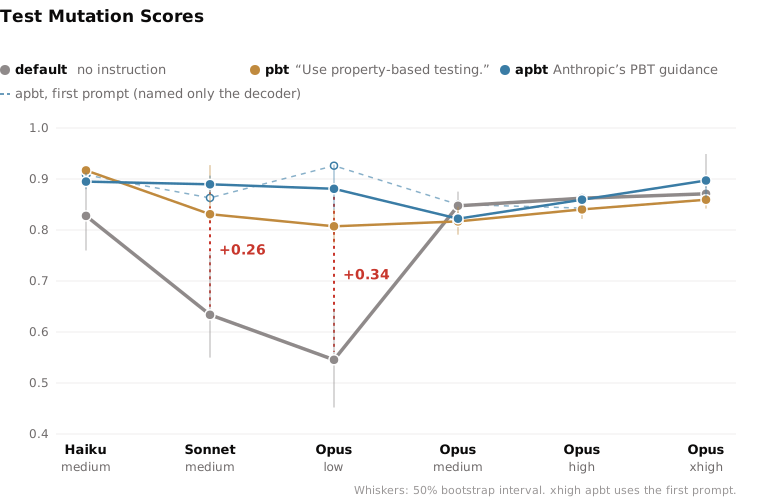
Sonnet en effort moyen et Opus en effort faible profitent largement du property-based testing sur cette tâche, par rapport à l’expérience par défaut. Haiku y gagne moins, car ses tests par défaut sont déjà bons. À partir d’Opus en effort moyen, la simple consigne « Use property-based testing. » pourrait légèrement nuire, et il n’est pas clair si les consignes de test plus détaillées d’Anthropic aident ou gênent Opus 5.5.
Résultat 3 : les méthodologies de test n’affectent pas la fonction
Les consignes de property-based testing n’influencent pas la façon dont le code de la tâche a été écrit. Les configurations les plus fortes ont bien obtenu de meilleurs taux de compression, mais le prompt demandait seulement une sortie d’au plus 1,25 fois la taille de zstd -1, pas le meilleur taux possible.
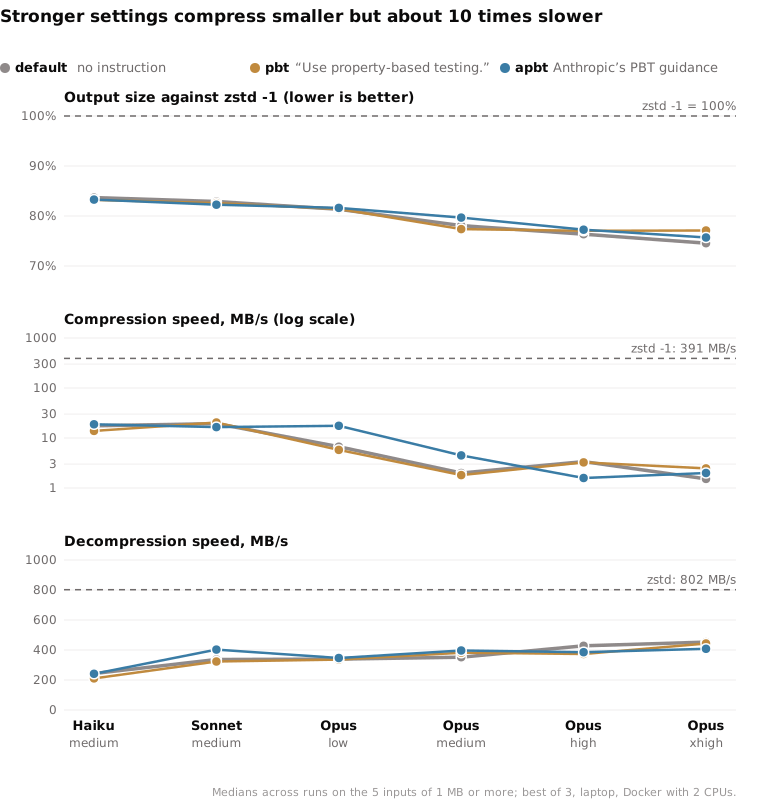
Aucune des solutions n’approche la vitesse de la véritable implémentation de zstd, mais la tâche ne fixait aucun objectif de performance. Les solutions compressaient bel et bien, puisque la taille de sortie faisait partie de la suite de tests.
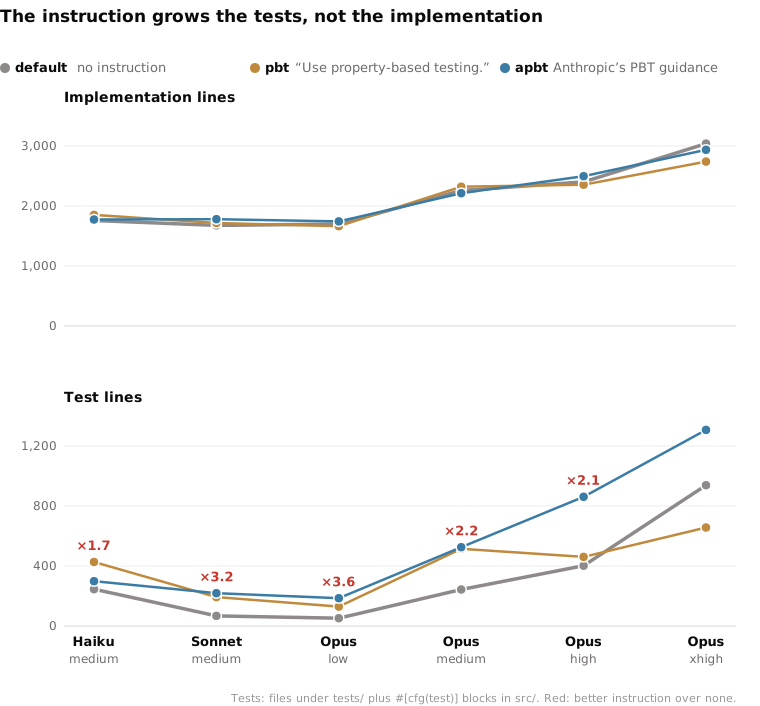
Les consignes de property-based testing ont généralement produit davantage de code de test, souvent deux à trois fois plus, mais il reste modeste face à l’implémentation : quelques centaines de lignes contre environ 2 000.
Résultat 4 : le choix du modèle et l’effort sont les principaux leviers de coût
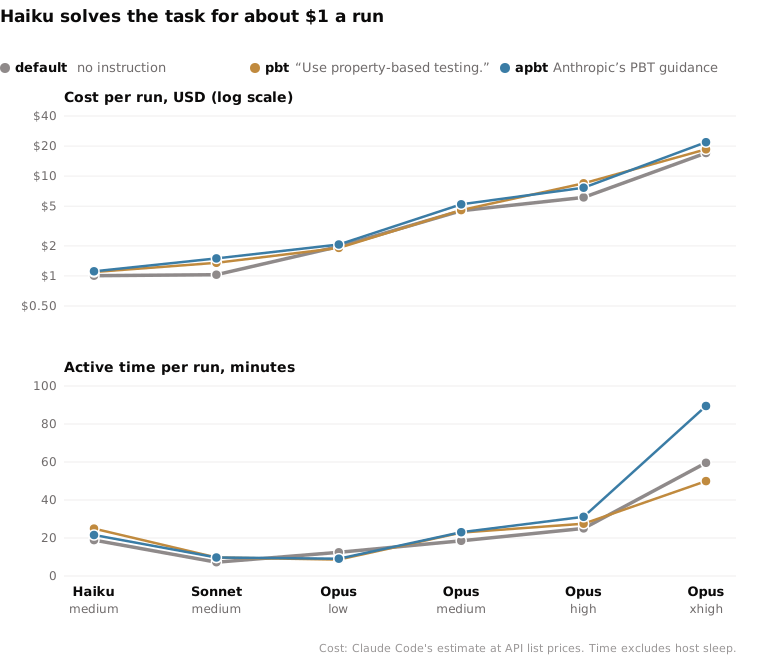
J’aurais considéré qu’une implémentation de Zstd en Rust était un problème difficile. J’ai été bluffé que Haiku puisse désormais le résoudre, et à ce prix : environ 1 $ par exécution, contre 5 à 8 $ pour Opus en effort moyen et élevé. Nous n’avons exécuté xhigh que deux fois par condition : c’était clairement d’un coût absurde et d’une grande lenteur, et la tâche ne nécessitait pas ce niveau d’effort.
Conclusions
Mon enseignement personnel : Sonnet 5.5 et Haiku 5.5 sont vraiment bons aujourd’hui, et on peut les améliorer par des consignes. Opus 5.5 en effort moyen et au-delà est bon d’emblée, et des consignes supplémentaires n’apportent pas grand-chose, ce qui rejoint ce que Dan a observé avec GPT-5.6 Sol. Cela dit, si vous écrivez de gros volumes de code, les modèles moins puissants coûtent nettement moins cher que d’utiliser Opus par défaut. Et même au sein de la gamme Opus, réfléchir davantage ne donne pas de meilleurs résultats dès lors qu’une tâche se situe confortablement sous le plafond de capacité du modèle.