
Nous avons donné une mémoire à notre agent : bâtir un LLM Wiki sur des sources qui ne tiennent jamais en place
Ingénierie13 juil. 2026
Notre agent redéduisait sans cesse les mêmes réponses à partir de zéro, en dépensant minutes et dollars à chaque question. Nous lui avons donc donné une mémoire persistante. Voici comment nous l'avons construite, ce que nous avons testé et ce qui a changé.
Le problème
Notre agent répond aux questions de l'équipe. Posez-lui une question et il va chercher : il explore nos connaissances internes, notre code, Notion, Slack, GDrive et le web, synthétise une réponse avec des citations pour chaque affirmation, puis vous répond.
Notre première approche était la génération augmentée par récupération (RAG) classique : récupérer les documents bruts pertinents au moment de la requête et les injecter dans le contexte. Les mêmes faits étaient récupérés et redéduits des mêmes documents encore et encore, et la qualité des réponses ne valait jamais mieux que les extraits qui se retrouvaient dans le contexte à ce moment-là.
Une alternative est l'idée qu'Andrej Karpathy a esquissée sous le nom de « LLM Wiki » : au lieu de récupérer des documents bruts à chaque requête, on compile une seule fois ce que l'on apprend dans une couche de connaissances persistante, maintenue par l'IA, puis on la réutilise. On paie une fois pour comprendre quelque chose, puis on répond à partir d'un savoir accumulé qui s'améliore avec le temps au lieu de tout redéduire à partir de zéro. Nous n'en sommes qu'au début de la construction d'un tel système, mais voici ce que nous avons appris jusqu'ici.
Ce que la recherche n'a pas encore rattrapé : nos sources bougent
Voici la subtilité. La plupart des travaux sur le LLM Wiki supposent un wiki local et personnel : vos sources brutes sont des fichiers qui vous appartiennent, et vous savez exactement quand l'un d'eux est ajouté ou modifié. Dans ces conditions, la maintenance est simple : quand un fichier change, il suffit de demander au LLM de recompiler les pages concernées.
Mais nous voulions un wiki partagé, compilé à partir de sources partagées comme Notion, GDrive ou le web, qui changent constamment sous nos pieds, modifiées par des personnes qui ignorent qu'un wiki dépend d'elles. Nous ne recevons aucun signal lorsqu'une source évolue, ni lorsqu'une information récente apparaît dans un recoin que nous n'avons jamais indexé. Garder une couche de connaissances compilée fiable alors que ses sources sous-jacentes dérivent en silence s'est révélé être la partie difficile, et la recherche existante ne l'a pas encore beaucoup explorée dans le contexte d'un LLM wiki.
Nous n'avons pas encore entièrement résolu ce problème. Aujourd'hui, nous nous appuyons sur deux éléments. Une tâche de lint hebdomadaire détecte a posteriori les contradictions et les affirmations obsolètes. Et surtout, au moment de la requête, nous revalidons chaque fait du wiki auprès de la source liée avant de l'utiliser. Cela signifie que nous payons encore pour récupérer la source à chaque réponse, un coût que le wiki pourrait sinon réduire.
Ce qu'est réellement notre wiki
Le wiki est un répertoire de fichiers markdown situé sur une branche dédiée de l'un de nos dépôts : un fichier markdown par entrée, chacun avec des métadonnées en frontmatter, organisés dans une arborescence de dossiers imbriqués. Le wiki est donc versionné, comparable et relisible comme n'importe quel autre code. Il n'y a aucune infrastructure distincte à surveiller.
Mais ce n'est pas un simple tas de fichiers à plat, et pour comprendre pourquoi, partons de ce qui se passe quand une question arrive : nous la classons d'abord dans une catégorie. Chaque catégorie dispose d'un ensemble défini de sources auxquelles elle a le droit de puiser.
C'est cette classification qui structure l'ensemble. La première idée était de découper un grand wiki en sous-wikis plus petits, un par catégorie, ce qui facilite la navigation pour le LLM. Une fois la question classée, nous l'orientons vers le sous-wiki correspondant, et l'agent lit dans ce sous-wiki (puis y écrit) précisément. Cela circonscrit la recherche : une question sur une catégorie n'a jamais à patauger parmi des entrées (ou des sources) qui relèvent d'une autre, ce qui réduit à la fois le bruit et le coût.
La navigation dans la structure repose sur des fichiers index.md. À chaque niveau d'imbrication, le LLM maintient un fichier index.md qui résume ce qui se trouve en dessous. Pour trouver quelque chose, l'agent parcourt l'arbre de haut en bas : il lit l'index à chaque niveau pour décider quel dossier ou fichier ouvrir ensuite, plutôt que de tout balayer. Ce sont les index qui permettent à un wiki en croissance de rester navigable au lieu de s'effondrer en un tas indifférencié de markdown.
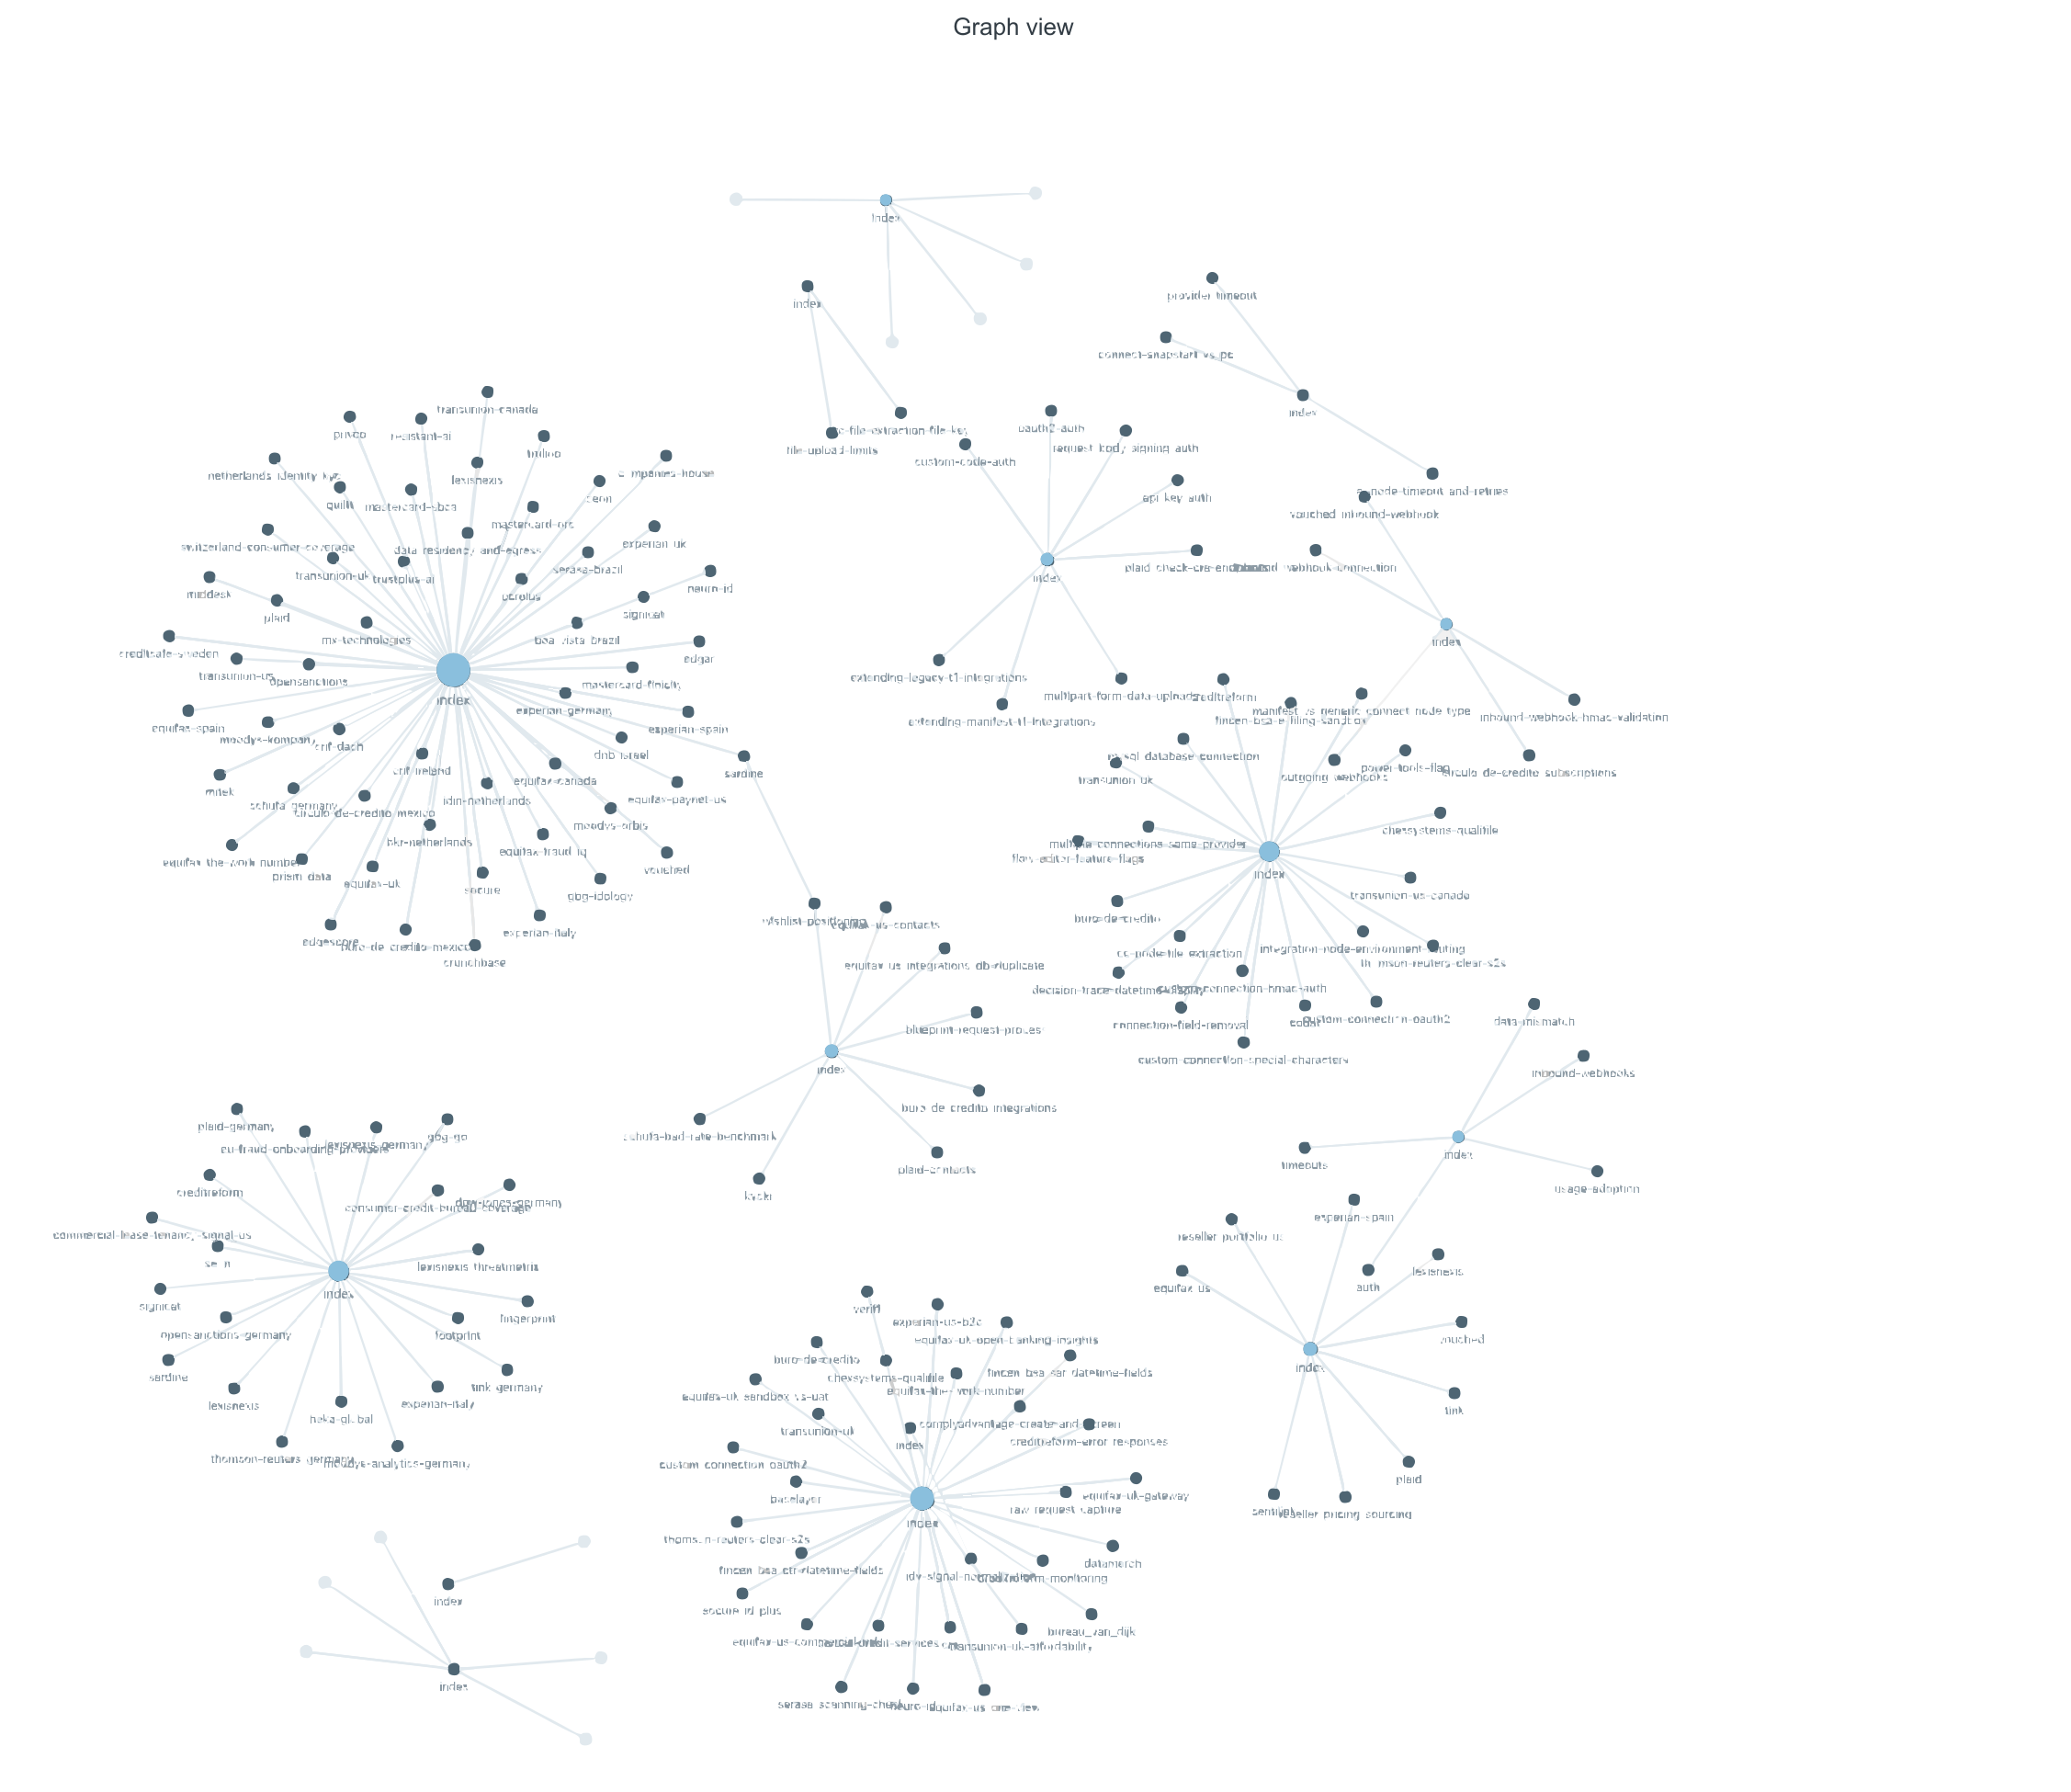
La conception de Karpathy commence par une étape d'ingestion dédiée : on dépose des sources et le LLM les compile en pages en amont. Notre flux est différent : nous n'ingérons pas à l'avance, car nos sources ne nous le permettent pas. Elles sont partagées et changent constamment, de sorte que tout ce que nous compilerions d'avance pourrait être périmé avant d'être interrogé. À la place, le wiki se remplit comme sous-produit des réponses aux questions. Il nous reste deux mouvements :
- Requête + ingestion : une personne pose une question. L'agent récupère les entrées du wiki pertinentes, vérifie qu'elles sont toujours exactes par rapport à leurs sources, contrôle aussi les autres sources partagées à la recherche d'éléments nouveaux à ajouter, puis rédige une réponse citée, en signalant au passage les conflits qu'il rencontre. Lorsqu'une réponse reçoit un retour positif, c'est le signal pour la conserver : nous ne stockons pas la réponse elle-même, mais nous en distillons les affirmations factuelles et les réécrivons sous forme d'entrées, afin que le savoir soit sous une forme réutilisable pour la requête suivante.
- Lint : un contrôle de santé périodique empêche le wiki de se dégrader en grossissant. Tout ce qui ne demande pas de jugement humain est résolu automatiquement ; le reste est remonté dans un rapport.
Comment fait-on une recherche dans un tas de markdown ?
Toute la valeur d'un wiki dépend de la capacité de l'agent à trouver la bonne entrée lorsqu'il pose une question. Si ce point est mal réglé, on manque des connaissances que l'on possède ou on ramène du bruit qui pollue la réponse.
Nous avons examiné quatre stratégies de récupération.
- grep : comptage de mots. On recherche directement les mots de la requête dans chaque entrée, on compte les occurrences et on renvoie les plus fortes. C'est la référence de base.
- SQLite FTS5 + BM25 : la recherche par mots-clés bien faite. Même idée, mais notée avec la formule BM25 au-dessus de l'index plein texte FTS5 intégré à SQLite. Un stemmer de Porter ramène les formes d'un mot à une racine commune, et BM25 ajoute la pondération par rareté et la normalisation par longueur qui manquent à un simple grep.
- Recherche vectorielle : correspondance sémantique. On transforme chaque entrée et la question en vecteurs qui capturent le sens, puis on cherche l'entrée dont le vecteur est le plus proche de celui de la question.
- Jugement du LLM : laisser le modèle choisir. C'est l'approche avec laquelle nous avons démarré en production. Trois passes : (1) lire
index.mdet présélectionner des entrées à partir de leurs résumés, (2) lire le frontmatter de l'ensemble présélectionné pour écarter les entrées non pertinentes, (3) ne lire en profondeur que ce qui reste pour un jugement final. Intelligent, mais avec une latence et un coût élevés, et très dépendant de la qualité de l'index et du frontmatter, que le LLM écrit lui-même : les erreurs s'accumulent donc.
En plus de ces méthodes, nous avons aussi essayé une approche hybride : combiner deux d'entre elles (jugement du LLM et recherche vectorielle) avec la fusion de rangs réciproques (Reciprocal Rank Fusion, RRF). La RRF est un moyen simple de fusionner deux listes classées en une seule.
Ce que disent les chiffres
Nous avons évalué les quatre méthodes selon deux axes : la qualité des résultats et leur rapidité.
Nous avons exécuté cette évaluation sur un ensemble de 24 requêtes portant sur notre wiki de production, qui comptait alors 88 entrées.
Pour la qualité, nous avons utilisé un ensemble de requêtes annotées de référence et mesuré, à un seuil K (testé à 3, 5 et 10) :
- Rappel (recall) : parmi toutes les entrées correctes (« gold »), quelle fraction avons-nous trouvée (
gold trouvées ÷ total gold). - Taux de réussite (hit-rate) : fraction des requêtes pour lesquelles au moins une entrée gold apparaît parmi les K premières.
- Gold manquées / non-gold récupérées : nombre moyen d'entrées correctes ignorées et nombre moyen d'entrées parasites ramenées.
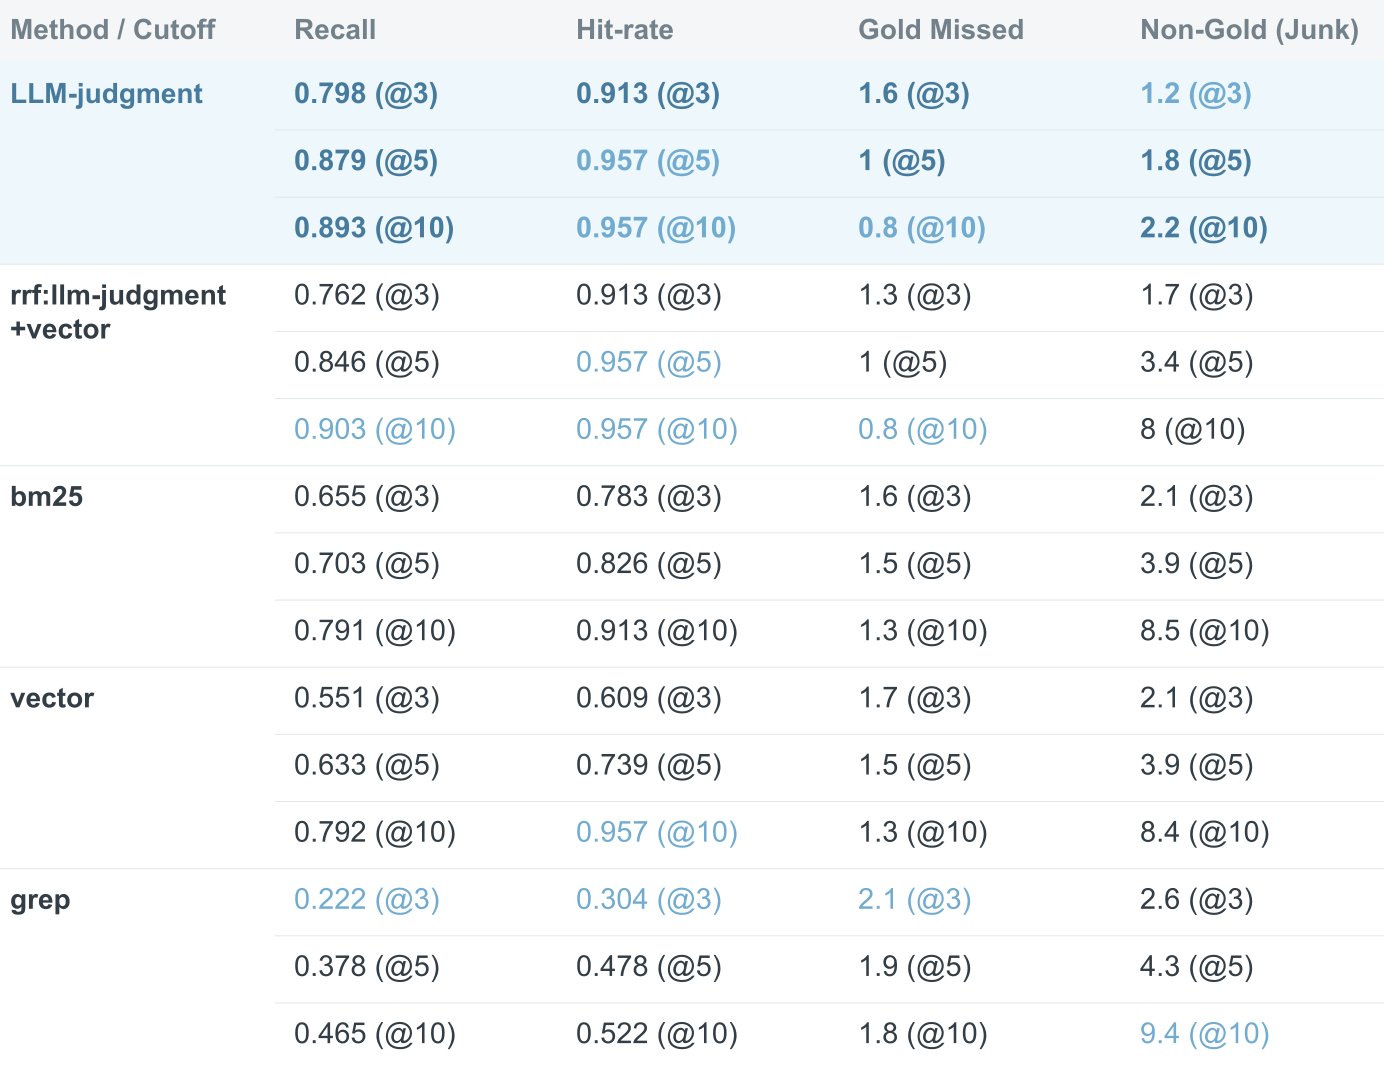
Plusieurs éléments ressortent. grep n'est pas viable. Il ne trouve guère plus d'un cinquième des entrées pertinentes à K=3 et ne se rattrape jamais vraiment. Le jugement du LLM est le leader en précision, avec le meilleur rappel et le meilleur taux de réussite à K faible et les résultats les plus propres (le plus faible nombre d'entrées non-gold, soit parasites, et de loin). Le fusionner avec la recherche vectorielle via la RRF permet de gagner un peu de rappel à K=10 (0.90), mais le nombre d'entrées parasites grimpe à 8 : on trouve un peu plus en ramenant beaucoup plus de bruit. BM25 est le juste milieu pragmatique : il bat la recherche vectorielle simple à K faible et se rapproche des méthodes à base de LLM, pour une fraction infime du coût.
Ce qui nous amène à ce coût. Côté latence, l'écart entre les méthodes était énorme :
| Méthode | Latence |
|---|---|
| Jugement du LLM | 69.1 s |
| BM25 | 0.47 ms |
| Vectorielle | 12.28 ms |
| grep | 6.00 ms |
L'essentiel : le jugement du LLM l'emporte en précision mais est environ 150 000× plus lent que BM25. C'est tout l'arbitrage. Ses 69 secondes par requête achètent les résultats les plus propres, tandis que BM25 vous mène presque aussi loin en une demi-milliseconde. Le camp qui l'emporte dépend de ce que vous cherchez à optimiser.
Par ailleurs, ces chiffres vont probablement évoluer à mesure que le wiki grandit. Nous nous attendons alors à un glissement vers une approche hybride, car chaque méthode de recherche est forte précisément là où les autres sont faibles : BM25 excelle sur les termes exacts, la recherche vectorielle capte le sens et le jugement du LLM apporte un raisonnement intelligent. Nous pensons que la fusion de deux méthodes ou plus sera la plus robuste à grande échelle.
Ce que le bénéfice pourrait être
Voici la tension. Comme nous revalidons actuellement chaque fait auprès de sa source en direct, nous ne capturons pas encore tout le bénéfice du wiki en production. Nous payons toujours pour récupérer la source au moment de répondre. Mais nous pouvons mesurer le plafond, avec notre configuration actuelle. Nous avons exécuté les mêmes requêtes de deux façons : avec l'agent qui valide chaque affirmation auprès de sa source documentée comme il le fait aujourd'hui, et avec lui qui répond à partir du wiki sans l'aller-retour de revalidation.
Sur quelques exécutions sélectionnées, en moyenne, une exécution est passée de 9 min 40 s et 2,50 $ avec consultation des sources en direct à 1 min 19 s et 0,98 $ en répondant directement depuis le wiki, soit environ 8 minutes 21 secondes et 1,52 $ économisés par exécution, 86 % plus rapide et 61 % moins cher. Et même ce chiffre « wiki seul » s'appuie encore sur le jugement du LLM pour la récupération, qui, comme nous l'avons vu plus haut, a sa propre latence. Remplacez-le par un moteur de récupération moins coûteux et le plancher devrait encore baisser.
C'est ce chiffre que nous visons. D'où une question : comment éviter la revalidation quand c'est sans risque ?
Où nous allons
Comme nous l'avons vu, la revalidation pèse lourd ici ; une amélioration consiste donc à ne revalider que lorsque c'est vraiment nécessaire. Le plan : stocker une empreinte légère de chaque source liée à côté de l'entrée du wiki, par exemple un horodatage last_updated_at ou un hash du contenu. Au moment de la requête, nous comparons l'empreinte actuelle à celle qui est stockée. Si elle n'a pas changé, nous savons que rien n'a bougé dans la source ; nous pouvons donc faire confiance au fait compilé du wiki et répondre immédiatement. Si elle a changé, nous revenons à la revalidation (et à la recompilation) de cette seule entrée.
C'est la partie enthousiasmante. Chaque question à laquelle l'agent répond rend le wiki un peu plus intelligent, et chaque amélioration que nous livrons s'ajoute aux précédentes. Nous allons combler l'écart sur la revalidation, réévaluer et affiner la récupération à mesure que le wiki grandit, et nous efforcer de prouver qu'une couche de connaissances partagée et auto-entretenue peut tenir à grande échelle. Nous pensons que c'est possible, et nous ne faisons que commencer.