
Property-based testing com o Claude


Dan Luu escreveu um post incrível no blog, Quão bem os agentes usam técnicas de teste e verificação?. Ele concluiu que instruções para usar uma técnica específica não ajudavam muito, mas que o property-based testing talvez tivesse algum valor discreto. Aquele post focava em modelos da OpenAI (Codex com GPT-5.6 Sol), então quis ver se o resultado se repetia em modelos da Anthropic. Isso levou a um mergulho profundo no desempenho dos modelos e a uma descoberta pessoal surpreendente sobre o quão bons os modelos da última geração realmente são. O Haiku 5.5 agora é um bom modelo de codificação com agentes!
A configuração do benchmark
Peça a um modelo que escreva um par compressor e descompressor Zstd em Rust, usando apenas a especificação do formato. Compare três condições: sem instruções de teste, "Use property-based testing." e o guia da própria Anthropic sobre testes baseados em propriedades. O guia da Anthropic é um conjunto de instruções detalhadas de 13 KB, o hypo.md command da pesquisa da Anthropic sobre testes baseados em propriedades com agentes, portado do Hypothesis para o proptest do Rust. Sem uso de internet e sem um oráculo real do zstd.
Resultado 1: até o Haiku já é bom
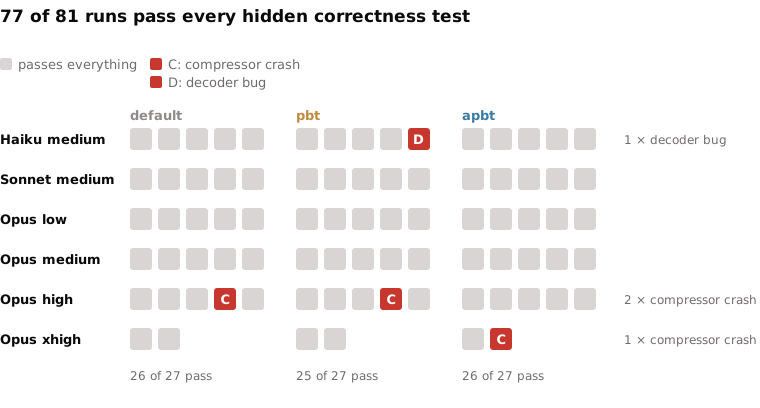
Todos os modelos conseguem fazer essa tarefa. A correção funcional foi testada com suítes ocultas criadas a partir do zstd de referência: 47 casos de decodificador, 17 casos de compressor, 400 frames do próprio gerador decodecorpus do zstd e 300 entradas de compressor geradas por fuzzing. Algumas execuções falharam (4 de 81), sem um padrão claro por modelo ou metodologia de teste. As falhas foram casos extremos, não problemas na lógica central: três compressores travaram quando um bloco inteiro de 128 KiB não pôde ser comprimido, e um decodificador rejeitou frames válidos.
Resultado 2: o property-based testing gera testes mais robustos em níveis mais baixos
Como a correção funcional não diferenciou os modelos, medimos a qualidade dos testes gerados com mutation testing: os testes conseguiam detectar bugs injetados no código depois? Aqui começamos a ver algum sinal sobre a qualidade de engenharia dos testes.
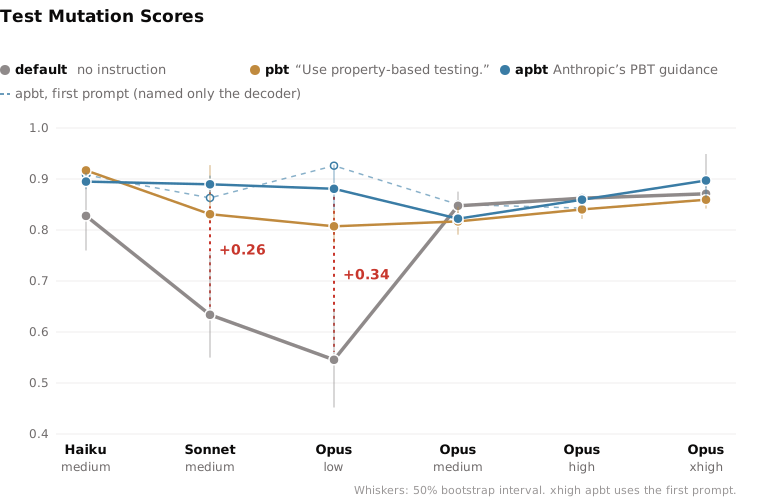
O Sonnet com esforço médio e o Opus com esforço baixo se beneficiam muito do property-based testing nessa tarefa, em comparação com a experiência padrão. O Haiku ganha menos, porque seus testes padrão já são bons. Com o Opus em esforço médio ou acima, a instrução simples "Use property-based testing." pode até prejudicar um pouco, e não está claro se a orientação de testes mais ampla da Anthropic ajuda ou atrapalha o Opus 5.5.
Resultado 3: as metodologias de teste não afetam a função
As instruções de property-based testing não afetam a forma como o código da tarefa foi escrito. As configurações mais fortes alcançaram taxas de compressão melhores, mas o prompt pedia apenas uma saída de até 1,25 vez o tamanho de zstd -1, e não a melhor taxa.
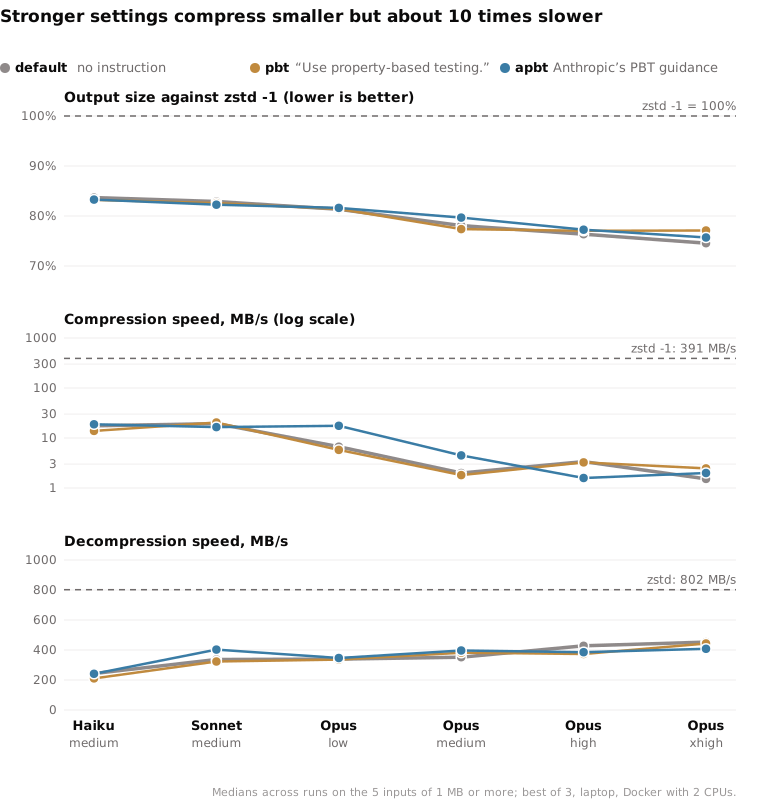
Nenhuma das soluções chegou perto da velocidade da implementação real do zstd, mas a tarefa não definia metas de desempenho. As soluções de fato comprimiam, porque o tamanho da saída fazia parte da suíte de testes.
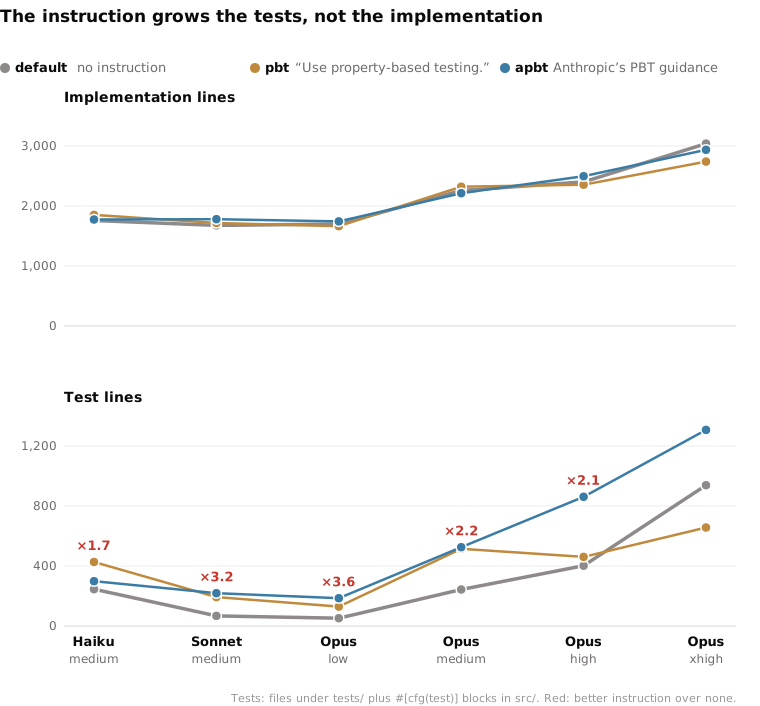
As instruções de property-based testing geralmente levaram a mais código de teste, muitas vezes de duas a três vezes mais, mas ainda pequeno perto da implementação: algumas centenas de linhas contra cerca de 2.000.
Resultado 4: a escolha do modelo e o esforço são os principais fatores de custo
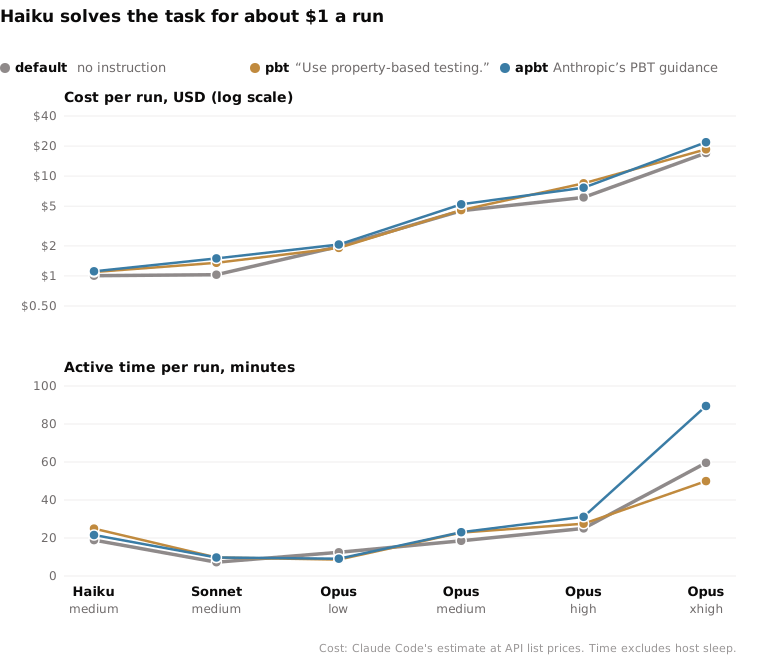
Eu teria considerado uma implementação de Zstd em Rust um problema difícil. Fiquei impressionado que o Haiku agora consiga resolvê-lo, e a esse preço: cerca de US$ 1 por execução, contra US$ 5 a US$ 8 do Opus em esforço médio e alto. Rodamos o xhigh apenas duas vezes por condição: era claramente absurdamente caro e lento, e a tarefa não exigia esse nível de esforço.
Conclusões
Meu aprendizado pessoal foi que o Sonnet 5.5 e o Haiku 5.5 estão muito bons agora e podem melhorar com instruções. O Opus 5.5 em esforço médio ou acima já é bom de fábrica, e você ganha pouco com instruções extras, o que ecoa o que o Dan encontrou com o GPT-5.6 Sol. Dito isso, se você escreve grandes volumes de código, os modelos mais fracos são bem mais baratos do que usar o Opus por padrão. Mesmo dentro da faixa do Opus, pensar mais não se traduz em resultados melhores quando a tarefa está confortavelmente dentro do limite de capacidade do modelo.