
Demos uma memória ao nosso agente: construindo uma LLM Wiki sobre fontes que nunca ficam paradas
Engenharia13 de jul. de 2026
Nosso agente vivia rederivando as mesmas respostas do zero, queimando minutos e dólares a cada pergunta. Então demos a ele uma memória persistente. Veja como a construímos, o que testamos e o que mudou.
O problema
Nosso agente responde às perguntas da equipe. Pergunte algo e ele vai atrás: pesquisa no nosso conhecimento interno, no nosso código, no Notion, no Slack, no GDrive e na web, sintetiza uma resposta com citações para cada afirmação e responde.
Nossa primeira abordagem foi a geração aumentada por recuperação (RAG) padrão: buscar os documentos brutos relevantes na hora da consulta e jogá-los no contexto. Os mesmos fatos eram recuperados e rederivados dos mesmos documentos várias vezes, e a qualidade da resposta era sempre tão boa quanto os trechos que acabavam entrando no contexto naquela vez.
Uma alternativa é a ideia que Andrej Karpathy esboçou como uma "LLM Wiki": em vez de recuperar documentos brutos a cada consulta, você compila uma vez o que aprende em uma camada de conhecimento persistente, mantida por IA, e a reutiliza. Você paga uma vez para entender algo e depois responde a partir de um conhecimento acumulado que melhora com o tempo, em vez de rederivá-lo do zero. Ainda estamos no começo da construção de uma, mas aqui está o que aprendemos até agora.
A parte que a pesquisa ainda não alcançou: nossas fontes mudam
Eis a complicação. A maior parte do trabalho sobre LLM Wiki por aí pressupõe uma wiki local e pessoal: suas fontes brutas são arquivos seus, e você sabe exatamente quando um é adicionado ou editado. Nessas condições, a manutenção é fácil: quando um arquivo muda, basta pedir ao LLM que recompile as páginas afetadas.
Mas nós queríamos uma wiki compartilhada compilada a partir de fontes compartilhadas como Notion, GDrive ou a web, que mudam o tempo todo debaixo dos nossos pés, editadas por pessoas que nem imaginam que uma wiki depende delas. Não recebemos nenhum sinal quando uma fonte muda ou quando surge informação nova em um canto que nunca indexamos. Manter confiável uma camada de conhecimento compilada quando as fontes que a sustentam mudam em silêncio acabou sendo a parte difícil, e a pesquisa existente ainda explorou pouco isso no contexto de uma LLM Wiki.
Ainda não resolvemos isso por completo. Hoje contamos com duas coisas. Um job semanal de lint pega contradições e afirmações desatualizadas depois do fato. E, mais importante, na hora da consulta revalidamos cada fato da wiki contra a fonte vinculada antes de usá-lo. Isso significa que ainda pagamos para buscar a fonte a cada resposta, um custo que a wiki poderia reduzir.
O que nossa wiki realmente é
A wiki é um diretório de arquivos markdown que vive em uma branch dedicada de um dos nossos repositórios: um arquivo markdown por entrada, cada um com metadados em frontmatter, organizados em uma estrutura de pastas aninhadas. Assim, a wiki tem controle de versão, permite diff e pode ser revisada como qualquer outro código. Não há nenhuma infraestrutura separada para cuidar.
Mas ela não é uma pilha única e plana de arquivos, e para entender por quê, comece pelo que acontece quando chega uma pergunta: primeiro a classificamos em uma categoria. Cada categoria tem um conjunto definido de fontes das quais pode se valer.
Essa classificação é o que sustenta a estrutura. A primeira ideia foi dividir uma wiki grande em sub-wikis menores, uma por categoria, o que facilita a navegação para o LLM. Depois que uma pergunta é classificada, nós a direcionamos para a sub-wiki correspondente, e o agente lê dela (e depois escreve de volta nela) especificamente. Isso mantém a recuperação delimitada: uma pergunta sobre uma categoria nunca precisa vasculhar entradas (ou fontes) que pertencem a outra, o que reduz tanto o ruído quanto o custo.
A navegação pela estrutura funciona com arquivos index.md. Em cada nível de aninhamento, o LLM mantém um index.md que resume o que existe abaixo dele. Para encontrar algo, o agente percorre a árvore de cima para baixo: lê o índice de cada camada para decidir qual pasta ou arquivo abrir em seguida, em vez de varrer tudo. Os índices são o que mantém uma wiki em crescimento navegável, em vez de virar um monte indiferenciado de markdown.
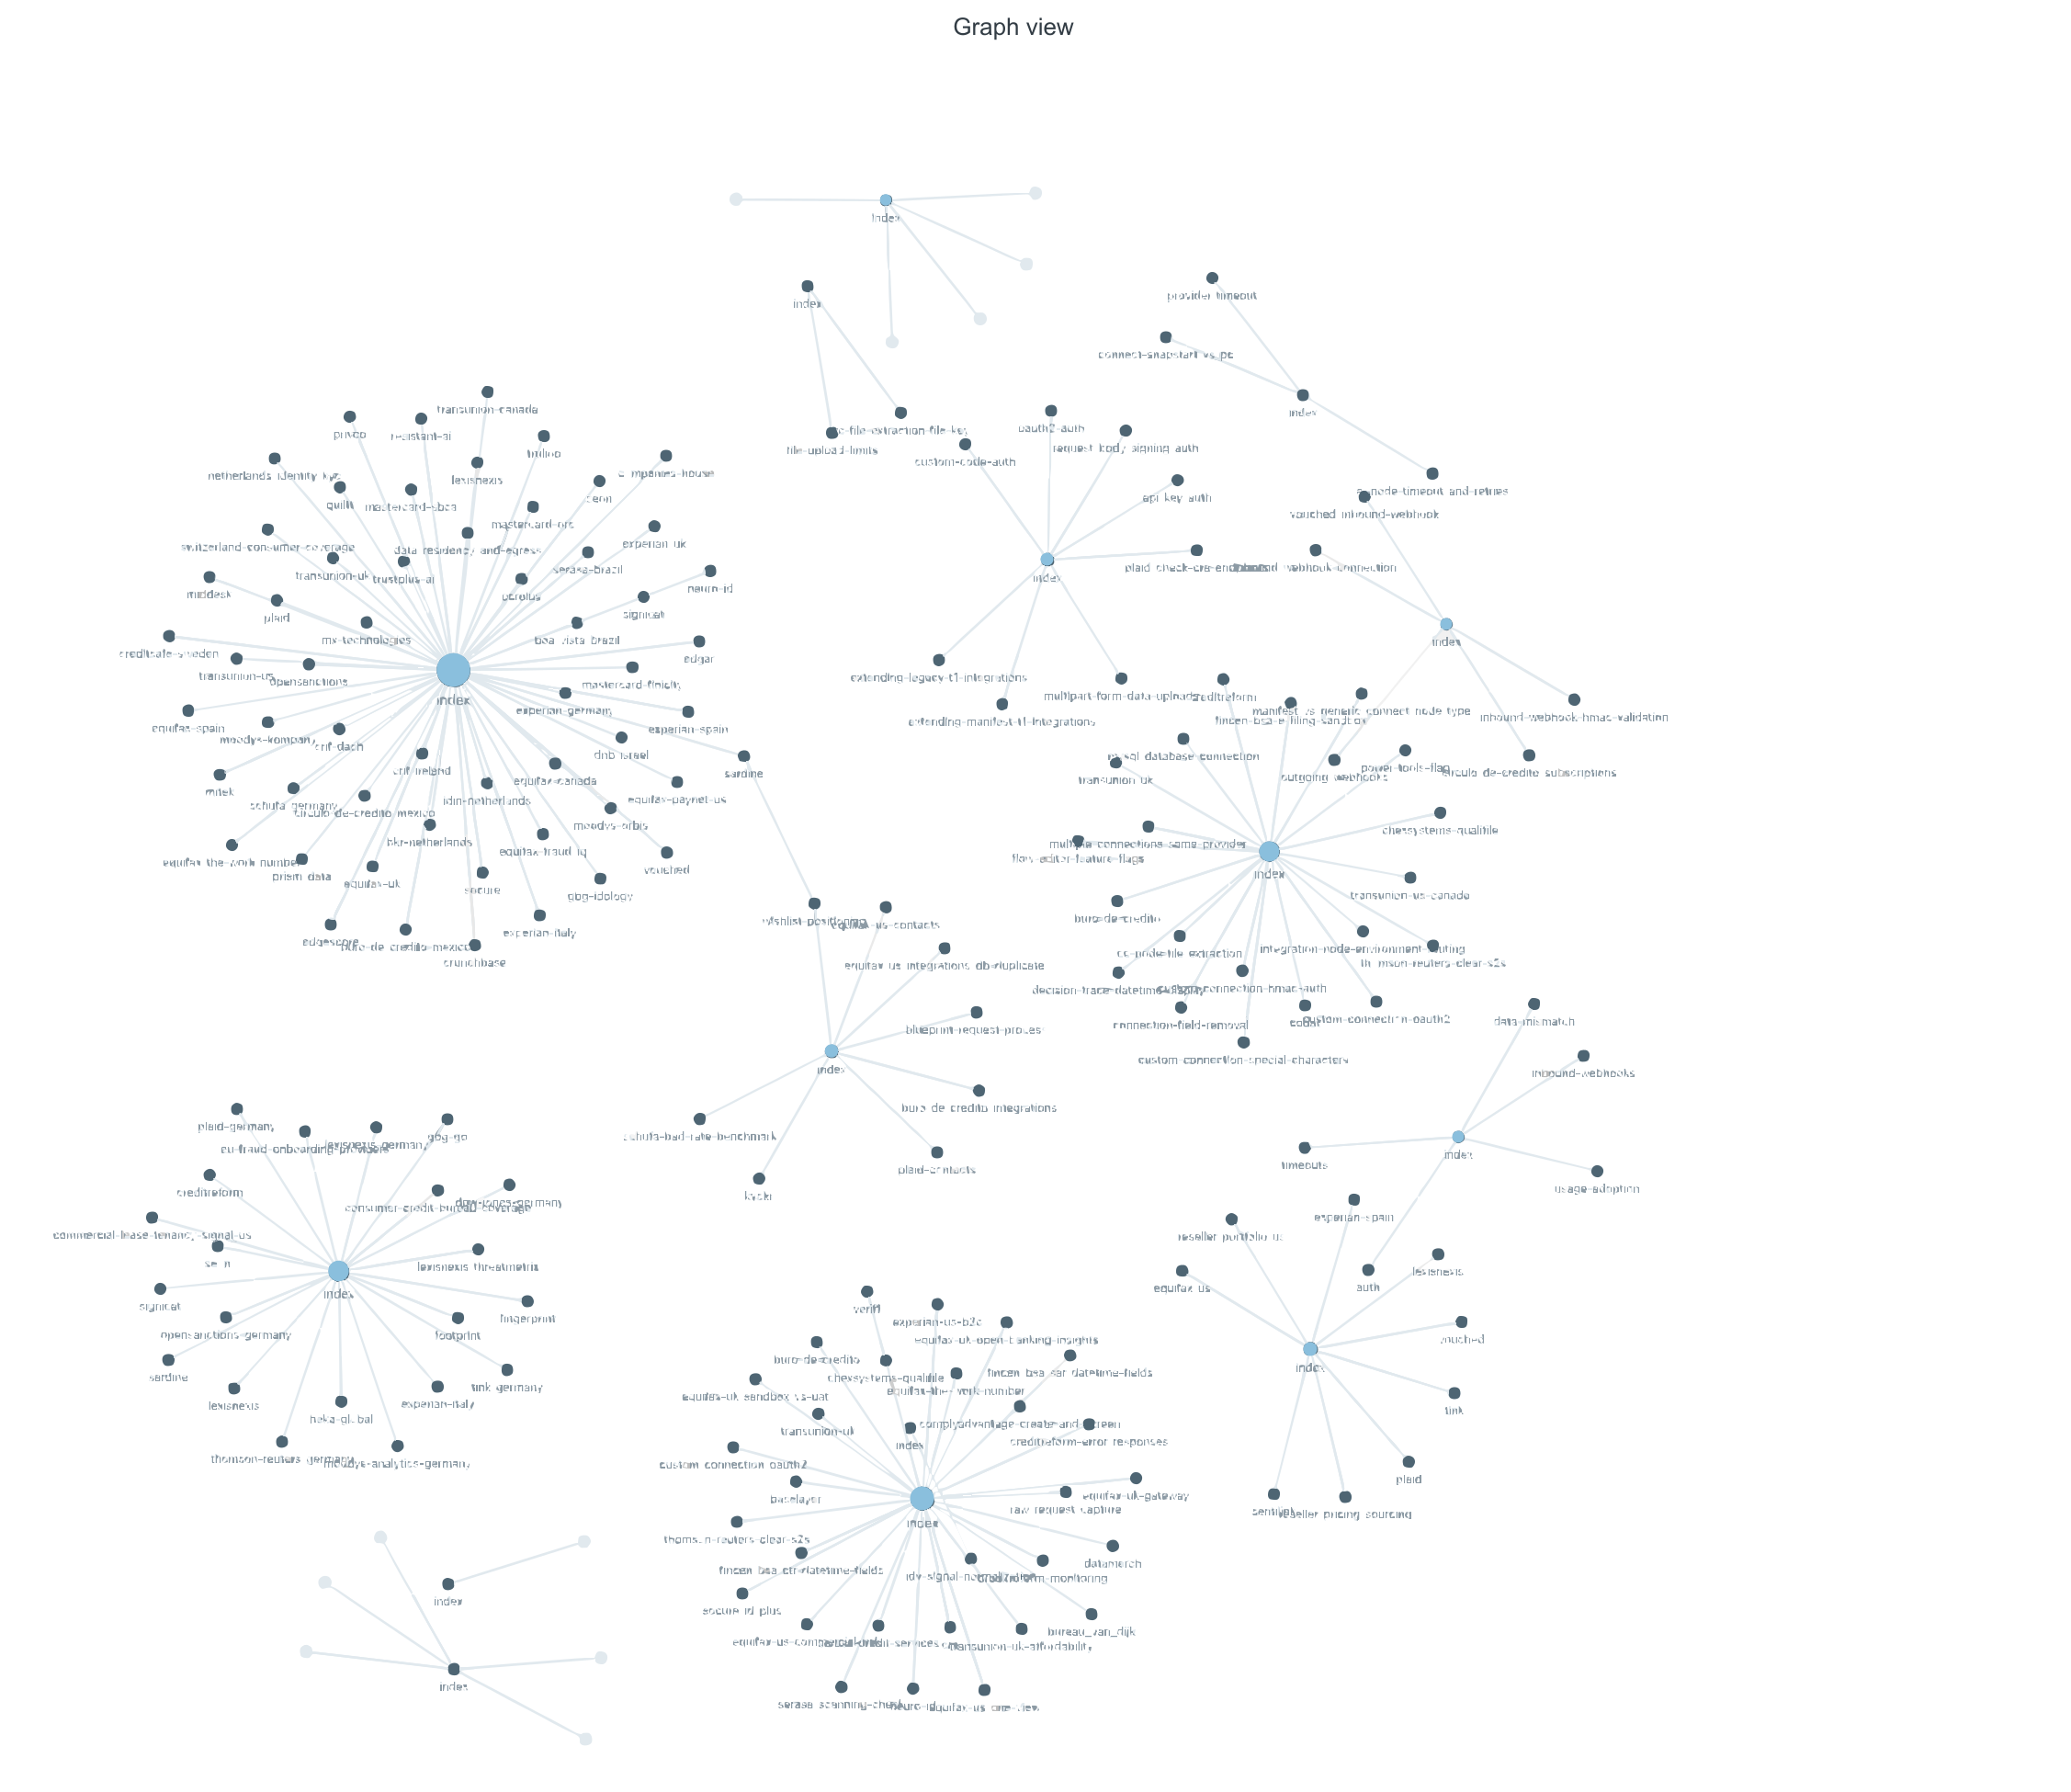
O design de Karpathy começa com uma etapa dedicada de ingestão: você joga as fontes e o LLM as compila em páginas de antemão. Nosso fluxo é diferente: não ingerimos com antecedência, porque nossas fontes não permitem. Elas são compartilhadas e mudam o tempo todo, então qualquer coisa compilada de antemão pode estar desatualizada antes de ser consultada. Em vez disso, a wiki se preenche como subproduto de responder perguntas. Isso nos deixa com dois movimentos:
- Consulta + ingestão: uma pessoa pergunta algo. O agente busca as entradas relevantes da wiki, confirma que ainda estão corretas em relação às fontes, verifica também as outras fontes compartilhadas em busca de algo novo que valha incluir e então escreve uma resposta com citações, sinalizando ainda quaisquer conflitos que encontrar pelo caminho. Quando uma resposta recebe feedback positivo, esse é o sinal para guardá-la: não armazenamos a resposta em si, mas destilamos as afirmações factuais nela contidas e as gravamos de volta como entradas, de modo que o conhecimento fique em um formato reutilizável para a próxima consulta.
- Lint: uma verificação periódica de saúde impede que a wiki se deteriore à medida que cresce. Tudo o que não exige julgamento humano é resolvido automaticamente; o resto vai para um relatório.
Como pesquisar em uma pilha de markdown?
Todo o valor de uma wiki depende de o agente encontrar a entrada certa quando faz uma pergunta. Se isso der errado, ou você perde um conhecimento que tem ou traz lixo que contamina a resposta.
Avaliamos quatro estratégias de recuperação.
- grep: contagem de palavras. Busca diretamente as palavras da consulta dentro de cada entrada, conta as ocorrências e devolve as maiores contagens. É a linha de base.
- SQLite FTS5 + BM25: busca por palavras-chave bem feita. A mesma ideia, mas pontuada com a fórmula BM25 sobre o índice de texto completo FTS5 nativo do SQLite. Um stemmer de Porter reduz as formas das palavras a uma raiz comum, e o BM25 acrescenta a ponderação por raridade e a normalização por tamanho que o grep simples não tem.
- Busca vetorial: correspondência semântica. Transforma cada entrada e a pergunta em vetores que capturam significado e então encontra a entrada cujo vetor aponta mais perto do da pergunta.
- Julgamento do LLM: deixar o modelo escolher. Foi a abordagem com que começamos em produção. Três passos: (1) ler o
index.mde pré-selecionar entradas a partir dos resumos, (2) ler o frontmatter do conjunto pré-selecionado para filtrar as irrelevantes, (3) fazer a leitura profunda apenas do que sobra para um julgamento final. É inteligente, mas tem alta latência e alto custo, e depende muito da qualidade do índice e do frontmatter, que o próprio LLM escreve, então os erros se acumulam.
Além dessas, também testamos um híbrido: combinar dois dos métodos (julgamento do LLM e busca vetorial) com Reciprocal Rank Fusion (RRF). O RRF é uma forma simples de mesclar duas listas ranqueadas em uma só.
O que os números disseram
Avaliamos os quatro métodos em dois eixos: quão bons são os resultados e quão rápidos eles são.
Executamos isso com um conjunto de 24 consultas sobre nossa wiki de produção, que tinha 88 entradas na época.
Para a qualidade usamos um conjunto de consultas com rótulos de referência (gold) e medimos, no corte K (testado em 3, 5 e 10):
- Recall: de todas as entradas corretas ("gold"), que fração encontramos (
gold encontradas ÷ total de gold). - Hit-rate: fração das consultas em que pelo menos uma entrada gold apareceu entre as K primeiras.
- Gold perdidas / não-gold recuperadas: média de entradas corretas que ficaram de fora e média de lixo trazido junto.
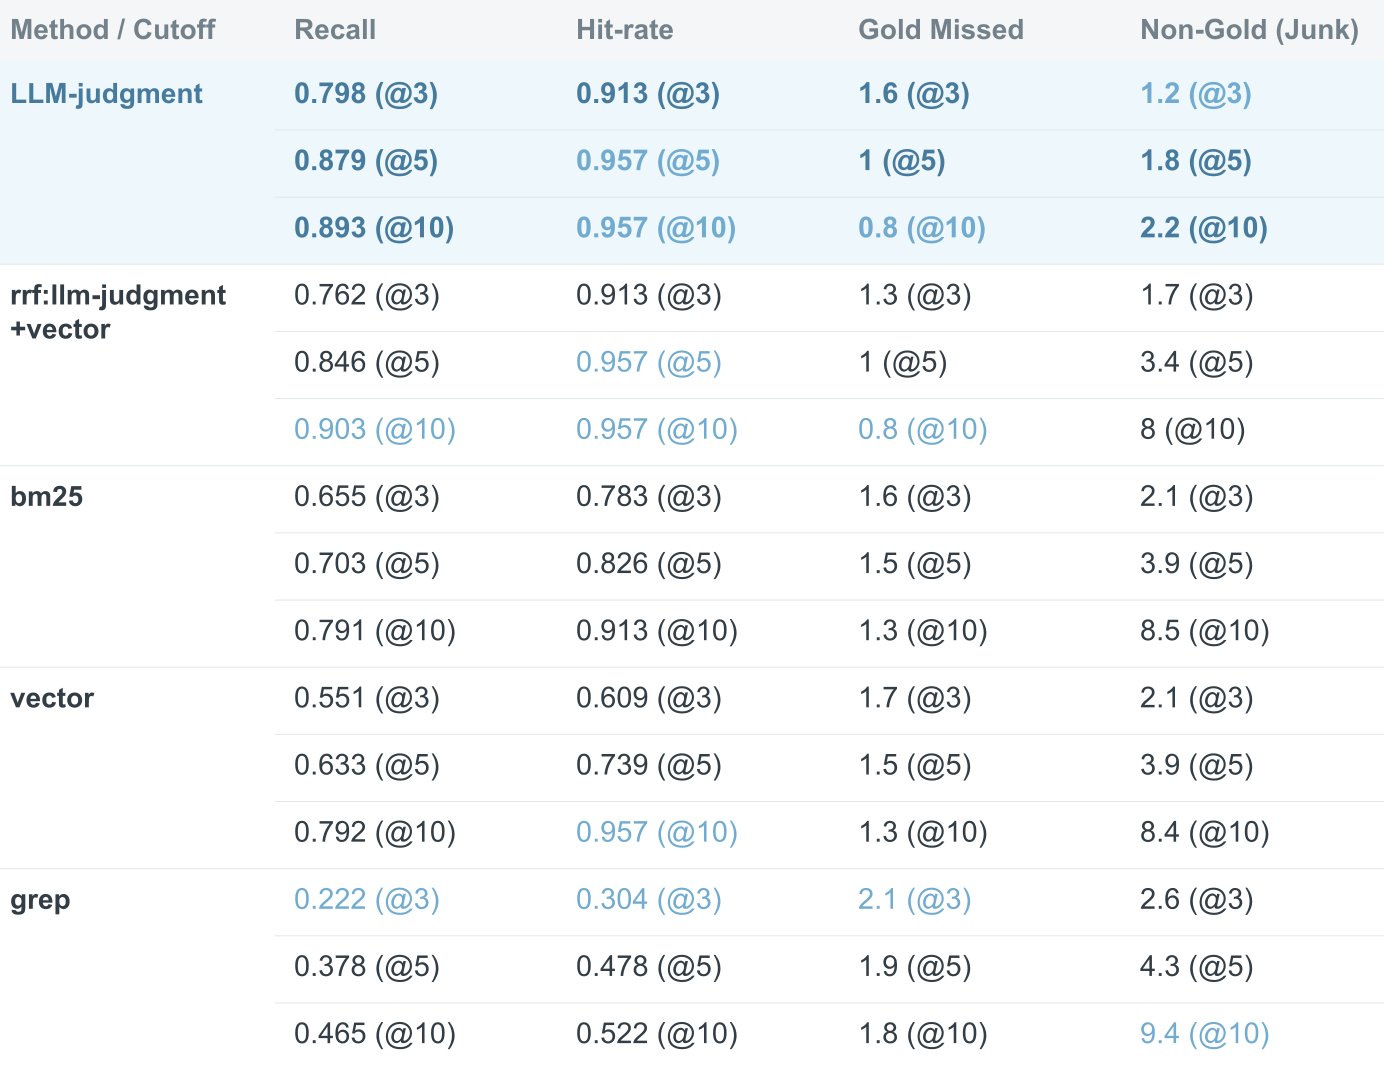
Algumas coisas chamam a atenção. O grep não é viável. Ele encontra pouco mais de um quinto das entradas relevantes em K=3 e nunca se recupera de verdade. O julgamento do LLM lidera em acurácia, com o melhor recall e hit-rate em K baixo e os resultados mais limpos (a menor contagem de não-gold/lixo por ampla margem). Fundi-lo com a busca vetorial via RRF rende um recall um pouco maior em K=10 (0.90), mas a contagem de lixo salta para 8: você encontra um pouco mais arrastando muito mais ruído. O BM25 é o meio-termo pragmático: ele supera a busca vetorial simples em K baixo e chega perto dos métodos com LLM, por um custo que é um erro de arredondamento.
O que nos leva a esse custo. Na latência, a diferença entre os métodos foi enorme:
| Método | Latência |
|---|---|
| Julgamento do LLM | 69.1 s |
| BM25 | 0.47 ms |
| Vetorial | 12.28 ms |
| grep | 6.00 ms |
O destaque: o julgamento do LLM vence em acurácia, mas é cerca de 150.000× mais lento que o BM25. Esse é o trade-off. Seus 69 segundos por consulta compram os resultados mais limpos, enquanto o BM25 leva você quase até lá em meio milissegundo. Qual lado desse trade-off vence depende do que você está otimizando.
Além disso, esses números provavelmente vão mudar conforme a wiki crescer. Esperamos então que o desempenho migre para uma abordagem híbrida, porque cada método de busca é forte exatamente onde os outros são fracos: o BM25 acerta tokens exatos, o vetorial captura significado e o julgamento do LLM traz raciocínio inteligente. Fundir dois ou mais deles é o que esperamos que se sustente melhor em escala.
Qual poderia ser o retorno
Eis a tensão. Como hoje revalidamos cada fato contra a fonte ativa, ainda não estamos capturando em produção todo o benefício da wiki. Continuamos pagando para buscar a fonte ao responder. Mas podemos medir o teto, com a configuração atual. Executamos as mesmas consultas de duas formas: com o agente validando cada afirmação contra a fonte documentada, como faz hoje, e com ele respondendo a partir da wiki sem a ida e volta da revalidação.
Em algumas execuções selecionadas, em média, uma execução passou de 9 m 40 s e $2.50 com consultas às fontes ativas para 1 m 19 s e $0.98 respondendo direto da wiki, o que dá cerca de 8 minutos e 21 segundos e $1.52 economizados por execução, 86% mais rápido e 61% mais barato. E mesmo esse número só com a wiki ainda depende do julgamento do LLM para a recuperação, que, como vimos acima, tem uma latência considerável própria. Troque por um recuperador mais barato e o piso deve cair ainda mais.
Esse é o número que estamos perseguindo. Daí surge uma pergunta: como pular a revalidação quando é seguro fazê-lo?
Para onde estamos indo
Como vimos, a revalidação pesa bastante aqui, e por isso uma melhoria é revalidar apenas quando realmente for necessário. O plano: armazenar uma impressão digital barata de cada fonte vinculada junto com a entrada da wiki, como um timestamp last_updated_at ou um hash do conteúdo. Na hora da consulta, comparamos a impressão digital atual com a armazenada. Se não mudou, sabemos que nada na fonte se moveu, então podemos confiar no fato compilado da wiki e responder na hora. Se mudou, recorremos à revalidação (e à recompilação) apenas daquela entrada.
Essa é a parte empolgante. Cada pergunta que o agente responde deixa a wiki um pouco mais inteligente, e cada melhoria que entregamos se soma à anterior. Vamos fechar a lacuna da revalidação, reavaliar e afinar a recuperação conforme a wiki crescer e nos empenhar em provar que uma camada de conhecimento compartilhada e autossustentada aguenta a escala. Achamos que sim, e estamos só começando.