
Property-based testing con Claude


Dan Luu escribió un excelente artículo, ¿Qué tan bien usan los agentes las técnicas de prueba y verificación?. Concluyó que las instrucciones de usar una técnica en particular no ayudaban mucho, pero que el property-based testing quizá tenía algún valor leve. Ese artículo se centraba en los modelos de OpenAI (Codex con GPT-5.6 Sol), así que quise comprobar si el resultado se trasladaba a los modelos de Anthropic. Eso derivó en un análisis a fondo del rendimiento de los modelos y en un descubrimiento personal sorprendente sobre lo buena que es en realidad la última generación de modelos. ¡Haiku 5.5 ya es un buen modelo de programación con agentes!
La configuración del benchmark
Se le pide a un modelo que escriba en Rust un par compresor y descompresor de Zstd usando únicamente la especificación del formato. Se comparan tres condiciones: sin instrucciones de testing, "Use property-based testing." y la propia guía de Anthropic sobre property-based testing. La guía de Anthropic es un conjunto de instrucciones detalladas de 13 KB, el hypo.md comando de la investigación de Anthropic sobre property-based testing con agentes, adaptado de Hypothesis a proptest de Rust. Sin acceso a internet y sin un oráculo real de zstd.
Resultado 1: hoy incluso Haiku lo hace bien
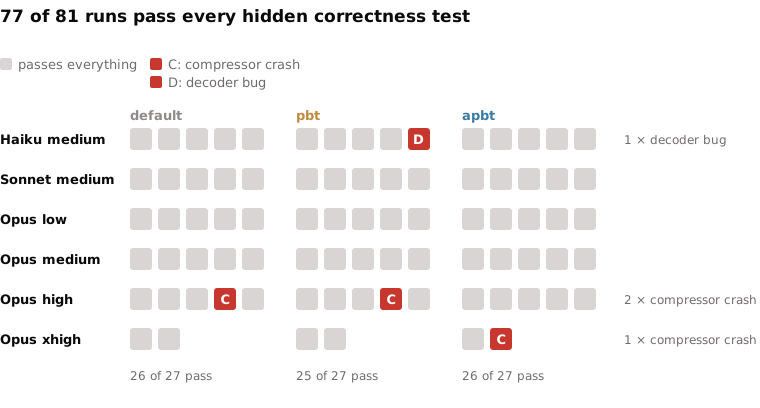
Todos los modelos pueden resolver esta tarea. La corrección funcional se probó con suites ocultas construidas a partir del zstd de referencia: 47 casos de decodificador, 17 casos de compresor, 400 frames del propio generador decodecorpus de zstd y 300 entradas de compresor generadas por fuzzing. Algunas ejecuciones fallaron (4 de 81), sin un patrón claro por modelo ni por metodología de testing. Los fallos fueron casos límite y no errores en la lógica central: tres compresores se cerraron con error cuando un bloque completo de 128 KiB no se podía comprimir, y un decodificador rechazó frames válidos.
Resultado 2: El property-based testing genera pruebas más robustas en los niveles más bajos
Como la corrección funcional no diferenció a los modelos, medimos la calidad de las pruebas generadas con mutation testing: ¿podían las pruebas detectar errores inyectados después en el código? Aquí empezamos a ver alguna señal sobre la calidad de ingeniería de las pruebas.
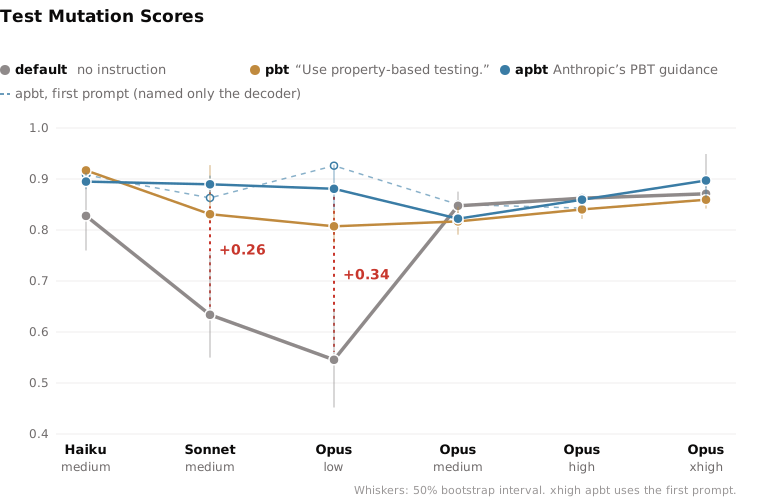
Sonnet con esfuerzo medio y Opus con esfuerzo bajo se benefician mucho del property-based testing en esta tarea, en comparación con la experiencia predeterminada. Haiku gana menos, porque sus pruebas predeterminadas ya son buenas. Con Opus en esfuerzo medio o superior, la instrucción simple "Use property-based testing." podría perjudicar ligeramente, y no está claro si la guía de testing más extensa de Anthropic ayuda o estorba a Opus 5.5.
Resultado 3: Las metodologías de testing no afectan la funcionalidad
Las instrucciones de property-based testing no afectan la forma en que se escribió el código de la tarea. Las configuraciones más potentes sí lograron mejores tasas de compresión, pero el prompt solo pedía una salida de hasta 1,25 veces el tamaño de zstd -1, no la mejor tasa posible.
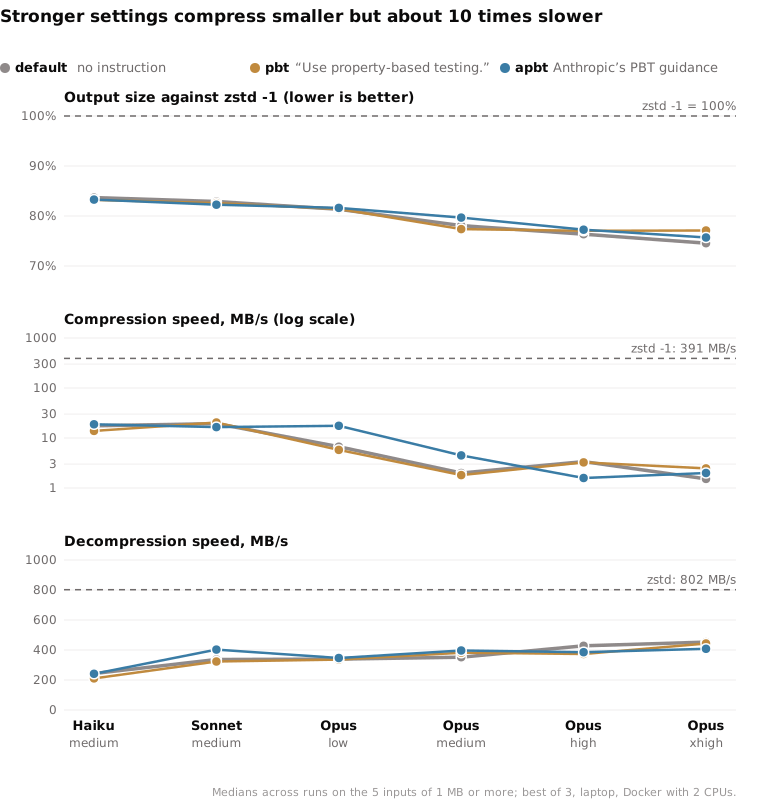
Ninguna de las soluciones se acercó a la velocidad de la implementación real de zstd, pero la tarea no fijaba objetivos de rendimiento. Aun así, las soluciones realmente comprimían, porque el tamaño de salida formaba parte de la suite de pruebas.
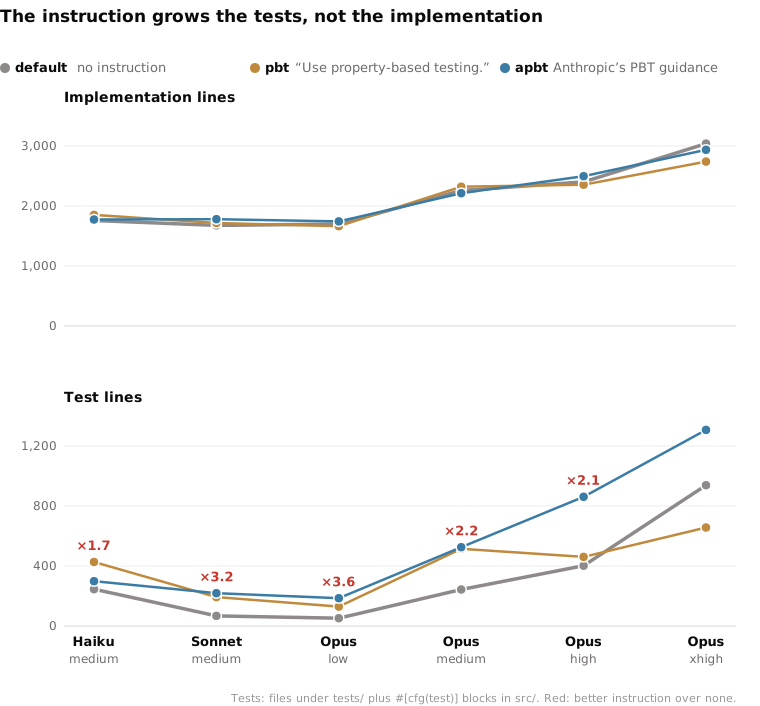
Las instrucciones de property-based testing solían generar más código de prueba, a menudo de dos a tres veces más, pero sigue siendo poco frente a la implementación: unos pocos cientos de líneas contra unas 2000.
Resultado 4: La elección del modelo y el esfuerzo son los principales factores de costo
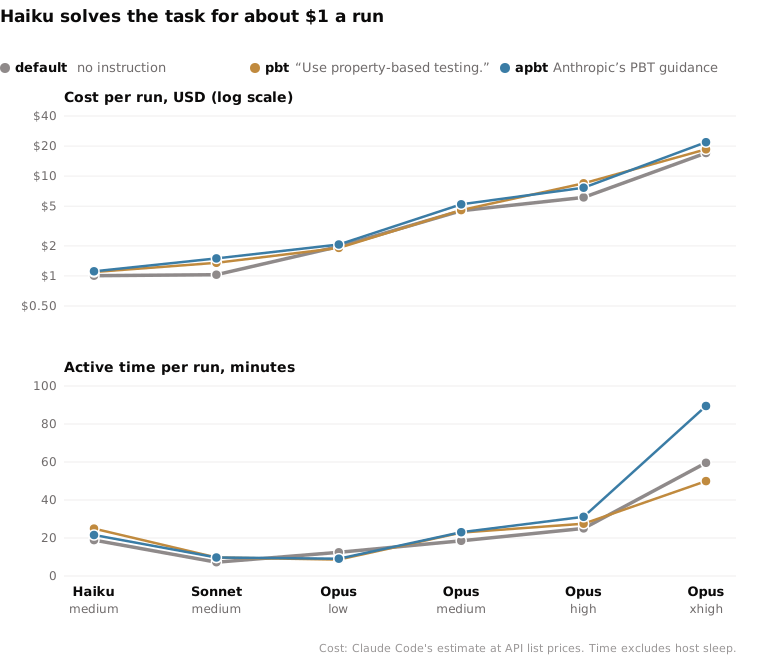
Yo habría considerado un problema difícil implementar Zstd en Rust. Me sorprendió que Haiku ahora pueda resolverlo, y a ese precio: unos 1 USD por ejecución, frente a entre 5 y 8 USD de Opus con esfuerzo medio y alto. Solo ejecutamos xhigh dos veces por condición: era claramente absurdo en costo y lentitud, y la tarea no requería ese nivel de esfuerzo.
Conclusiones
Lo que aprendí personalmente es que Sonnet 5.5 y Haiku 5.5 son realmente buenos hoy, y se pueden mejorar con instrucciones. Opus 5.5 con esfuerzo medio o superior funciona bien de entrada y no se gana mucho con instrucciones adicionales, lo que coincide con lo que encontró Dan con GPT-5.6 Sol. Dicho esto, si se escribe un gran volumen de código, los modelos más débiles son bastante más baratos que usar Opus por defecto. Incluso dentro de la gama de Opus, pensar más no se traduce en mejores resultados una vez que la tarea está cómodamente dentro del techo de capacidad del modelo.