
Le dimos una memoria a nuestro agente: construir un LLM Wiki sobre fuentes que nunca se quedan quietas
Ingeniería13 jul 2026
Nuestro agente seguía derivando las mismas respuestas desde cero, y gastaba minutos y dólares en cada pregunta. Así que le dimos una memoria persistente. Así la construimos, qué probamos y qué cambió.
El problema
Nuestro agente responde preguntas del equipo. Le pregunta algo y sale a averiguarlo: busca en nuestro conocimiento interno, nuestro código, Notion, Slack, GDrive y la web, sintetiza una respuesta con citas para cada afirmación y responde.
Nuestro primer enfoque fue la generación aumentada por recuperación (RAG) estándar: traer los documentos originales relevantes en el momento de la consulta y volcarlos en el contexto. Los mismos datos se recuperaban y se volvían a derivar de los mismos documentos una y otra vez, y la calidad de las respuestas dependía solo de los fragmentos que se hubieran cargado en el contexto esa vez en particular.
Una alternativa es la idea que Andrej Karpathy esbozó como un "LLM Wiki": en lugar de recuperar documentos originales en cada consulta, se compila una sola vez lo que se aprende en una capa de conocimiento persistente, mantenida por IA, y se reutiliza. Se paga una vez por entender algo y luego se responde a partir de un conocimiento acumulado que mejora con el tiempo, en lugar de volver a derivarlo desde cero. Todavía estamos al principio de construir uno, pero esto es lo que hemos aprendido hasta ahora.
Lo que la investigación aún no ha abordado: nuestras fuentes cambian
Aquí está el matiz. La mayor parte del trabajo sobre LLM Wiki que existe asume un wiki local y personal: sus fuentes originales son archivos que usted posee y sabe exactamente cuándo se agrega o se edita uno. En esas condiciones el mantenimiento es fácil: cuando un archivo cambia, basta con pedirle al LLM que recompile las páginas afectadas.
Pero nosotros queríamos un wiki compartido, compilado a partir de fuentes compartidas como Notion, GDrive o la web, que cambian constantemente bajo nuestros pies, editadas por personas que no saben que un wiki depende de ellas. No recibimos ninguna señal cuando una fuente cambia, ni cuando aparece información nueva en un rincón que nunca hemos indexado. Mantener confiable una capa de conocimiento compilada cuando sus fuentes subyacentes se desvían en silencio resultó ser la parte difícil, y la investigación existente todavía no la ha explorado mucho en el contexto de un LLM Wiki.
Aún no lo hemos resuelto del todo. Hoy nos apoyamos en dos cosas. Un trabajo semanal de lint detecta contradicciones y afirmaciones obsoletas a posteriori. Y, lo más importante, en el momento de la consulta revalidamos cada dato del wiki contra su fuente vinculada antes de usarlo. Esto significa que seguimos pagando por consultar la fuente en cada respuesta, un costo que el wiki podría reducir de otro modo.
Qué es realmente nuestro wiki
El wiki es un directorio de archivos markdown que vive en una rama dedicada de uno de nuestros repositorios: un archivo markdown por entrada, cada uno con metadatos de frontmatter, organizados en una estructura de carpetas anidadas. Por lo tanto, el wiki tiene control de versiones, se puede comparar y revisar como cualquier otro código. No hay una pieza de infraestructura aparte que vigilar.
Pero no es un montón plano de archivos, y para ver por qué, empecemos por lo que ocurre cuando llega una pregunta: primero la clasificamos en una categoría. Cada categoría tiene un conjunto definido de fuentes en las que puede apoyarse.
Esa clasificación es en torno a lo que se construye la estructura. La primera idea fue dividir un wiki grande en subwikis más pequeños, uno por categoría, lo que facilita la navegación al LLM. Una vez clasificada una pregunta, la dirigimos al subwiki correspondiente, y el agente lee de ese subwiki (y luego escribe en él) específicamente. Esto mantiene acotada la recuperación: una pregunta sobre una categoría nunca tiene que abrirse paso entre entradas (o fuentes) que pertenecen a otra, lo que reduce tanto el ruido como el costo.
La navegación por la estructura se apoya en archivos index.md. En cada nivel de anidamiento, el LLM mantiene un index.md que resume lo que hay debajo. Para encontrar algo, el agente recorre el árbol de arriba abajo: lee el índice de cada capa para decidir qué carpeta o archivo abrir a continuación, en lugar de escanearlo todo. Los índices son lo que permite que un wiki en crecimiento siga siendo navegable en lugar de desplomarse en un montón indiferenciado de markdown.
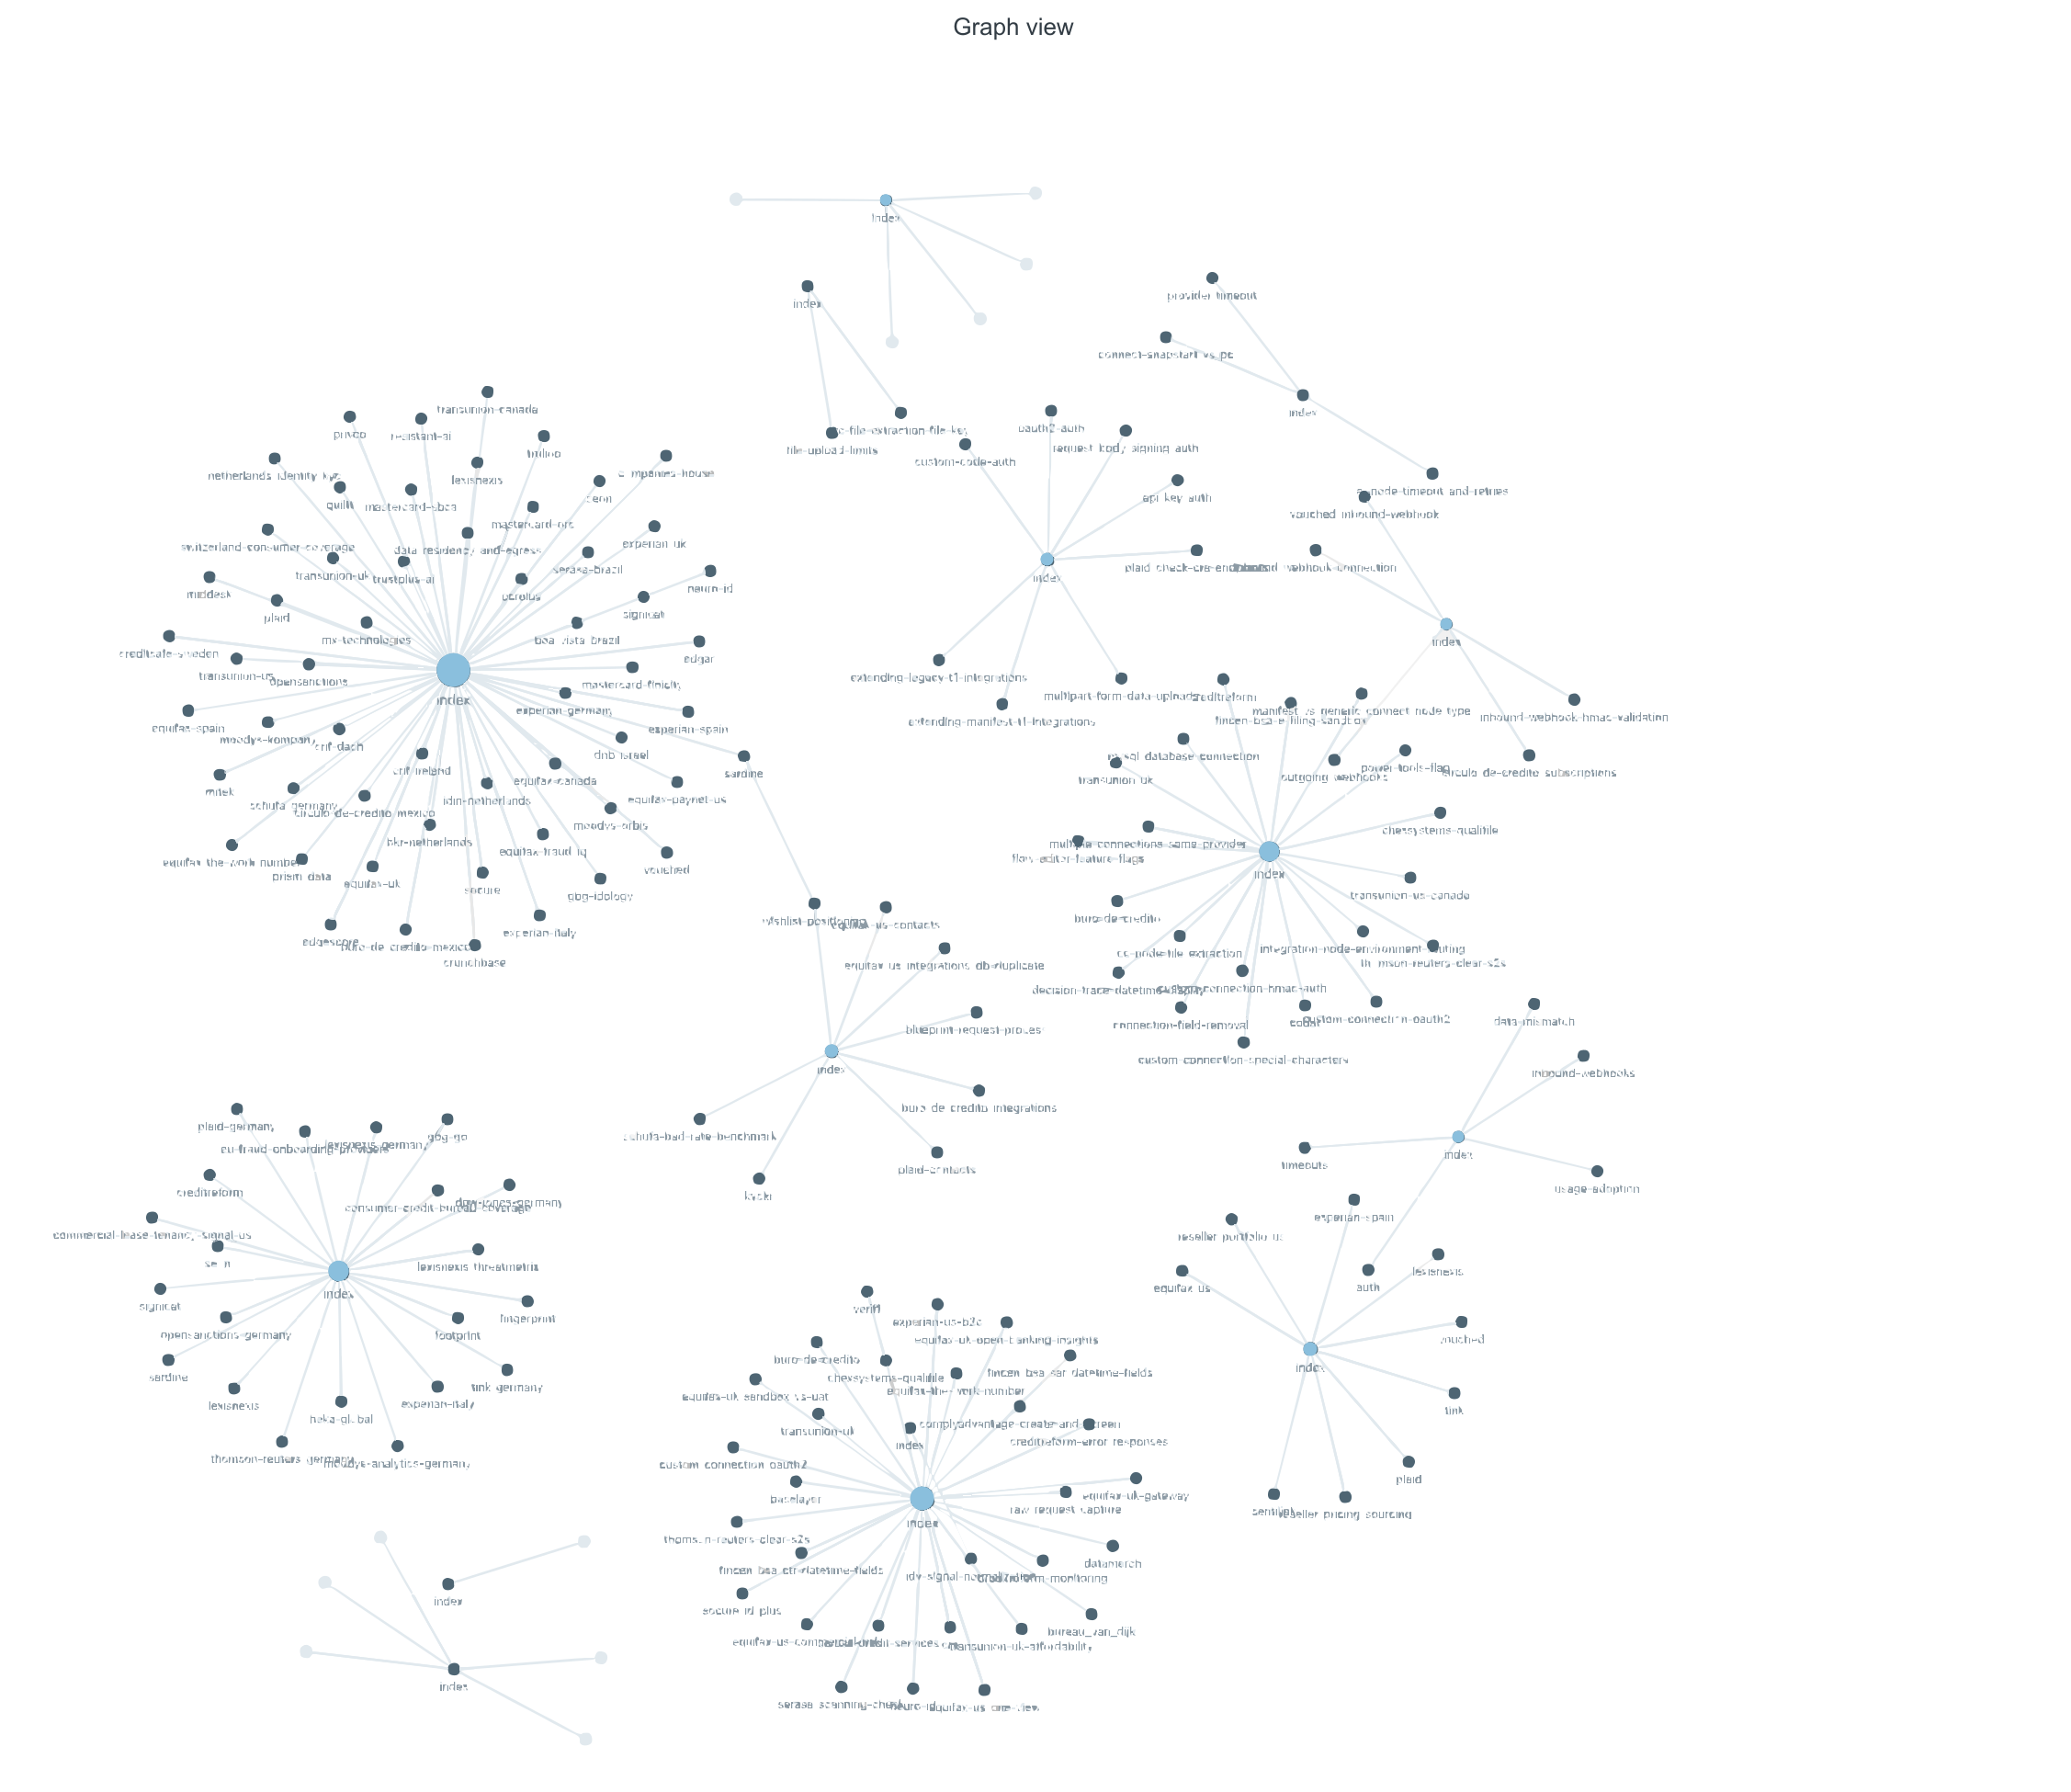
El diseño de Karpathy comienza con un paso dedicado de ingesta: se incorporan las fuentes y el LLM las compila en páginas desde el principio. Nuestro flujo es distinto: no hacemos la ingesta por adelantado, porque nuestras fuentes no lo permiten. Son compartidas y cambian constantemente, así que cualquier cosa que compiláramos de antemano podría estar obsoleta antes de que se consulte. En cambio, el wiki se llena solo como subproducto de responder preguntas. Eso nos deja con dos movimientos:
- Consulta + ingesta: una persona pregunta algo. El agente extrae las entradas relevantes del wiki, confirma que siguen siendo exactas frente a sus fuentes y también revisa las demás fuentes compartidas en busca de algo nuevo que valga la pena agregar; luego redacta una respuesta con citas y, además, señala los conflictos que encuentre en el camino. Cuando una respuesta recibe comentarios positivos, esa es la señal para conservarla: no almacenamos la respuesta en sí, sino que destilamos las afirmaciones factuales que contiene y las escribimos de vuelta como entradas, de modo que el conocimiento quede en una forma reutilizable para la siguiente consulta.
- Lint: una revisión periódica evita que el wiki se pudra a medida que crece. Todo lo que no necesita criterio humano se resuelve automáticamente; el resto se eleva en un informe.
¿Cómo se busca en un montón de markdown?
Todo el valor de un wiki depende de que el agente encuentre la entrada correcta cuando hace una pregunta. Si eso falla, o se pierde conocimiento que sí se tiene o se incorpora basura que contamina la respuesta.
Evaluamos cuatro estrategias de recuperación.
- grep: conteo de palabras. Busca directamente las palabras de la consulta dentro de cada entrada, cuenta las coincidencias y devuelve las que más tienen. Es la línea base.
- SQLite FTS5 + BM25: búsqueda por palabras clave bien hecha. La misma idea, pero puntuada con la fórmula BM25 sobre el índice de texto completo FTS5 integrado en SQLite. Un stemmer de Porter reduce las formas de las palabras a una raíz común, y BM25 añade la ponderación por rareza y la normalización por longitud que le faltan al grep simple.
- Búsqueda vectorial: coincidencia semántica. Se convierte cada entrada y la pregunta en vectores que capturan el significado, y se busca la entrada cuyo vector apunta más cerca del de la pregunta.
- Criterio del LLM: dejar que el modelo elija. Este es el enfoque con el que se empezó en producción. Tres pasadas: (1) leer
index.mdy preseleccionar entradas a partir de sus resúmenes, (2) leer el frontmatter del conjunto preseleccionado para descartar las irrelevantes, (3) leer a fondo solo lo que sobrevive para un juicio final. Es inteligente, pero con alta latencia y costo, y depende mucho de la calidad del índice y del frontmatter, que el propio LLM redacta, por lo que los errores se acumulan.
Además de estos, también probamos un enfoque híbrido: combinar dos de los métodos (el criterio del LLM y la búsqueda vectorial) con Reciprocal Rank Fusion (RRF). RRF es una forma sencilla de fusionar dos listas ordenadas en una.
Lo que dijeron los números
Evaluamos los cuatro métodos en dos ejes: qué tan buenos son los resultados y qué tan rápidos son.
Lo ejecutamos con un conjunto de 24 consultas sobre nuestro wiki de producción, que en ese momento tenía 88 entradas.
Para la calidad usamos un conjunto de consultas con etiquetas de referencia y medimos, con el corte K (probado en 3, 5 y 10):
- Recall: de todas las entradas correctas ("de referencia"), qué fracción encontramos (
referencia encontradas ÷ total de referencia). - Hit-rate: fracción de consultas en las que al menos una entrada de referencia apareció entre las K primeras.
- De referencia omitidas / no de referencia recuperadas: promedio de entradas correctas que se omitieron y promedio de basura que se incorporó.
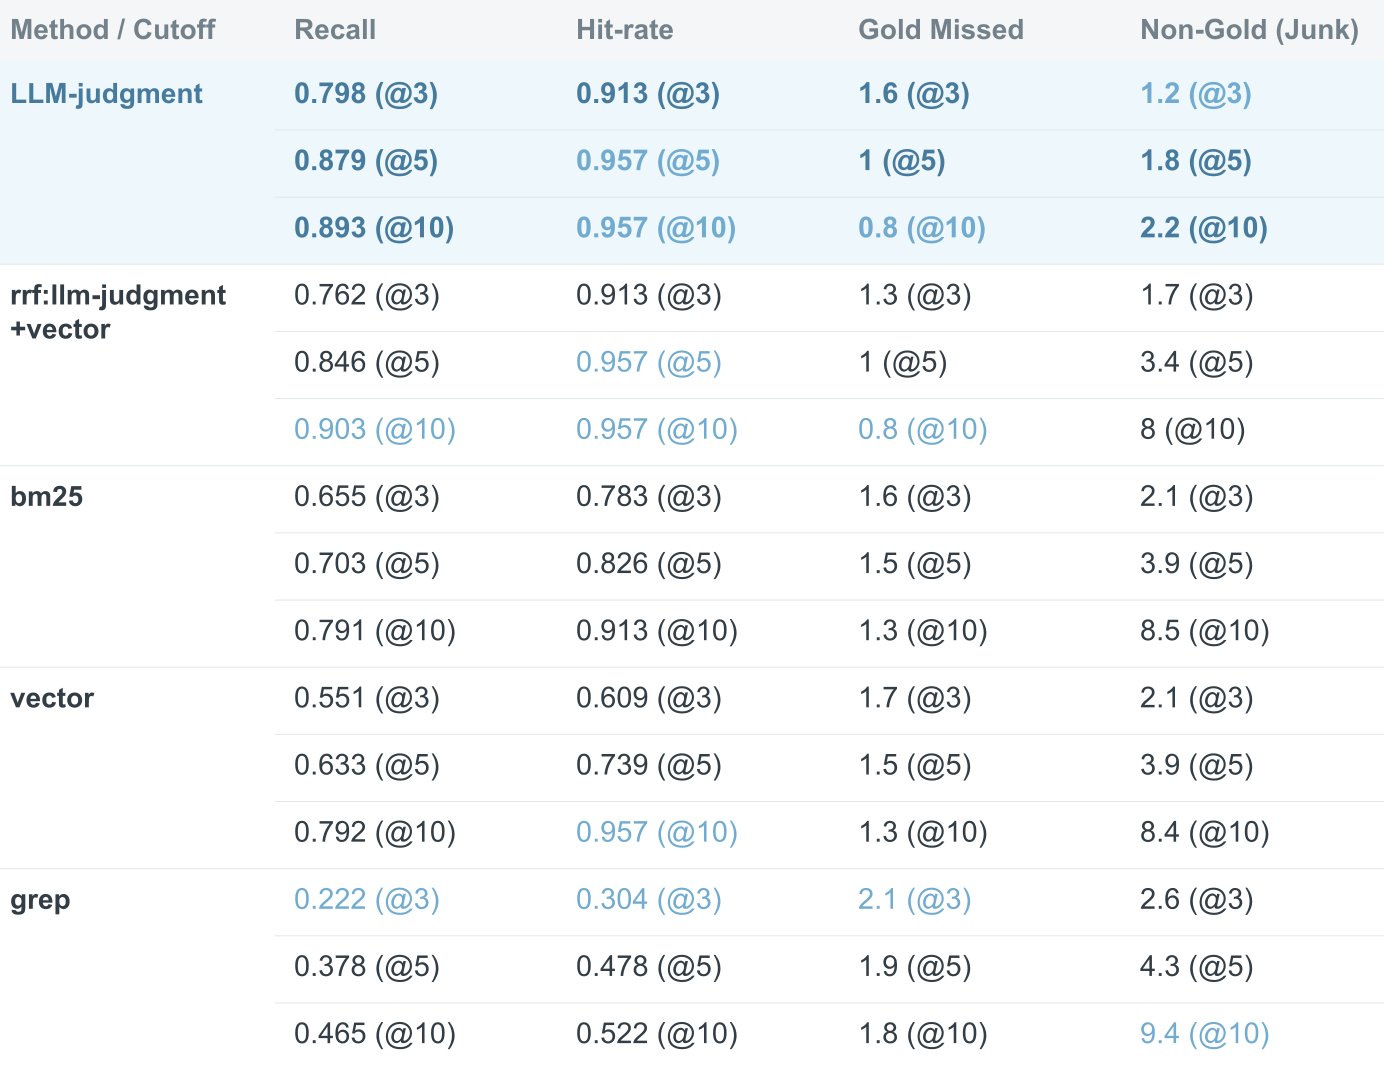
Algunas cosas saltan a la vista. grep no es viable. Encuentra apenas una quinta parte de las entradas relevantes con K=3 y nunca se recupera de verdad. El criterio del LLM lidera en precisión, con el mejor recall y hit-rate con K bajo y los resultados más limpios (el menor conteo de entradas no de referencia o basura por un amplio margen). Fusionarlo con la búsqueda vectorial mediante RRF logra un recall algo mayor con K=10 (0.90), pero el conteo de basura se dispara a 8: se encuentra un poco más a costa de arrastrar mucho más ruido. BM25 es el punto medio pragmático: supera a la búsqueda vectorial simple con K bajo y queda a un paso de los métodos con LLM, por un costo que es apenas un error de redondeo.
Lo que nos lleva a ese costo. En cuanto a la latencia, la diferencia entre métodos fue enorme:
| Método | Latencia |
|---|---|
| Criterio del LLM | 69.1 s |
| BM25 | 0.47 ms |
| Vectorial | 12.28 ms |
| grep | 6.00 ms |
El titular: el criterio del LLM gana en precisión, pero es unas 150,000 veces más lento que BM25. Esa es la disyuntiva. Sus 69 segundos por consulta compran los resultados más limpios, mientras que BM25 lo logra casi todo en medio milisegundo. Qué lado de la disyuntiva gana depende de lo que se esté optimizando.
Además, es probable que estos números cambien a medida que el wiki crezca. Esperamos entonces que el rendimiento se incline hacia un enfoque híbrido, porque cada método de búsqueda es fuerte justo donde los otros son débiles: BM25 acierta con los términos exactos, el vectorial capta el significado y el criterio del LLM aporta razonamiento inteligente. Fusionar dos o más de ellos es lo que esperamos que resista mejor a escala.
Cuál podría ser el beneficio
Esta es la tensión. Como actualmente revalidamos cada dato contra su fuente en vivo, todavía no estamos capturando todo el beneficio del wiki en producción. Seguimos pagando por consultar la fuente al responder. Pero podemos medir el techo, con nuestra configuración actual. Ejecutamos las mismas consultas de dos maneras: con el agente validando cada afirmación contra su fuente documentada, como lo hace hoy, y con él respondiendo desde el wiki sin el viaje de ida y vuelta de la revalidación.
En algunas ejecuciones seleccionadas, en promedio, una ejecución pasó de 9 m 40 s y $2.50 con consultas a las fuentes en vivo a 1 m 19 s y $0.98 respondiendo directamente desde el wiki, es decir, aproximadamente 8 minutos y 21 segundos y $1.52 de ahorro por ejecución, 86% más rápido y 61% más barato. E incluso esa cifra, solo con el wiki, sigue apoyándose en el criterio del LLM para la recuperación, que, como vimos, tiene una latencia considerable. Si se cambia por un recuperador más barato, el piso debería bajar aún más.
Esa es la cifra que perseguimos. De ahí surge una pregunta: ¿cómo omitimos la revalidación cuando es seguro hacerlo?
Hacia dónde vamos
Como vimos, la revalidación es un factor importante, así que una mejora es revalidar solo cuando realmente haga falta. El plan: guardar una huella barata de cada fuente vinculada junto con la entrada del wiki, como una marca de tiempo last_updated_at o un hash del contenido. En el momento de la consulta comparamos la huella actual con la almacenada. Si no ha cambiado, sabemos que nada en la fuente se movió, así que podemos confiar en el dato compilado del wiki y responder de inmediato. Si ha cambiado, volvemos a revalidar (y recompilar) solo esa entrada.
Esa es la parte emocionante. Cada pregunta que responde el agente hace al wiki un poco más inteligente, y cada mejora que lanzamos se suma a la anterior. Cerraremos la brecha de la revalidación, reevaluaremos y afinaremos la recuperación a medida que el wiki crezca, y buscaremos demostrar que una capa de conocimiento compartida y que se mantiene sola puede resistir a escala. Creemos que sí puede, y apenas estamos comenzando.