
Por qué la complejidad del KYB sigue creciendo y cómo los equipos pueden por fin adelantarse
Onboarding08 sept 2026
Durante años, la receta para un buen onboarding empresarial ha sido clara: mejores datos, mayor cobertura y más verificaciones automatizadas. A medida que los stacks de KYB han madurado, muchas partes del proceso se han vuelto más fáciles de automatizar y más confiables de forma aislada. Lo difícil ahora es lograr que todo cuadre.
Los equipos deben establecer qué datos están vigentes y cómo se relacionan entre sí las distintas pruebas. ¿El panorama combinado es lo bastante claro para que el caso avance? Nada de esto es nuevo para los equipos de onboarding con experiencia, pero la escala ha cambiado. A medida que crecen el volumen y la variedad de las pruebas, también aumenta la cantidad de interpretación necesaria.
Eso crea un problema de segundo orden para los stacks de KYB maduros. Añadir más datos no hace que el proceso sea automáticamente más eficiente. Una fuente adicional no aporta valor a menos que se pueda integrar fácilmente con el resto del caso.
Aquí es donde empiezan a surgir algunos de los casos de uso más creíbles de la IA agéntica. Lo que vemos en Taktile es que la IA tiene el mayor impacto en las áreas donde la información de base ya existe, pero los analistas necesitan conectar las pruebas y convertirlas en una siguiente acción clara.
Conclusiones clave
- La complejidad del KYB está creciendo porque los equipos deben conciliar más datos, pruebas y fuentes en cada caso.
- Más datos de KYB no significan automáticamente más eficiencia si los analistas aún deben conectarlos e interpretarlos manualmente.
- La IA agéntica es más útil cuando las pruebas ya existen pero los equipos necesitan ayuda para investigar, sintetizar y decidir qué sigue.
- Los primeros casos de uso incluyen revisiones de noticias adversas, resolución de titularidad, verificaciones de licencias y completitud de solicitudes.
- El mejor punto de partida es un problema de KYB acotado, con requisitos de pruebas, resultados y reglas de escalamiento claros.
- Los flujos de trabajo de KYB agénticos exitosos siguen requiriendo supervisión humana, monitoreo y ajuste continuo.
El costo de la complejidad es fácil de ocultar
A medida que los stacks de KYB se enriquecen, el costo de coordinar cada fuente adicional rara vez aparece como un único cuello de botella. Se acumula a lo largo del proceso. Discrepancias menores pueden desencadenar revisiones costosas y lentas sin ningún beneficio material.
Para los clientes empresariales complejos, esos costos pueden llegar a ser significativos. La complejidad y el riesgo no necesariamente crecen juntos, pero el esfuerzo operativo sí suele hacerlo. Por eso, una empresa con una estructura de propiedad, una presencia geográfica o un historial documental más complejos puede resultar costosa de incorporar mucho antes de volverse difícil de aceptar desde el punto de vista del riesgo.
Esa distinción importa porque cambia de dónde es probable que provengan las próximas mejoras de eficiencia. Una vez que las verificaciones básicas ya están automatizadas, una parte creciente de la oportunidad se concentra en un solo lugar: abaratar la conversión de las pruebas existentes en un caso resuelto.
Dónde los agentes ya son útiles
Algunos de los primeros casos de uso más claros de los agentes en KYB comparten una estructura común. La mayor parte de las pruebas necesarias para resolver la tarea ya está disponible y el resultado deseado se puede definir.
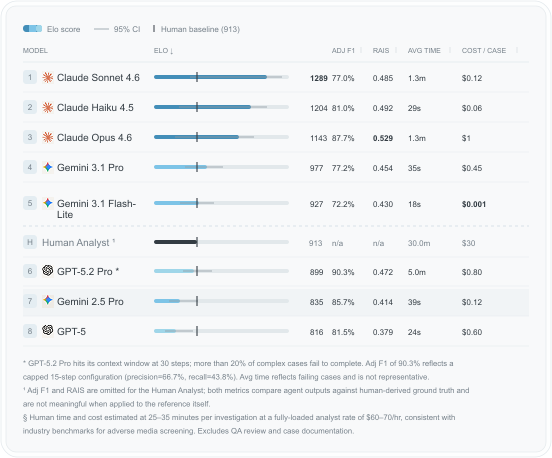
La investigación de noticias adversas es un buen ejemplo. KYBench de Taktile Labs puso a prueba agentes de IA en esta tarea con 47 empresas y 183 ejecuciones de agentes. En una rúbrica independiente de 20 puntos que evalúa la completitud de las pruebas, la precisión de las entidades, la calidad de las fuentes y la calibración del riesgo, los analistas humanos obtuvieron un promedio de 13,50 y los agentes de IA, de 14,60.
La experiencia de Yuliya Kazakevich en Cash App ofrece un segundo ejemplo de KYB. Su equipo usó LLM para señalar productos que podrían requerir verificaciones de licencias adicionales y luego un agente para ejecutar verificaciones de entidades empresariales, recuperar los datos de licencias pertinentes y generar una narrativa prellenada para operaciones. Según Yuliya, el enfoque combinado redujo el tiempo de los casos de KYB en aproximadamente un 70 %.
Los flujos de trabajo son distintos, pero la oportunidad de fondo es similar. En ambos casos, la información en gran medida ya existe; la carga operativa surge de convertirla en una respuesta utilizable y revisable.
El mismo principio puede extenderse a otras partes del onboarding. Un agente de resolución de titularidad puede revisar la información de los registros y los documentos del cliente para construir un panorama de la propiedad y detectar inconsistencias. Un agente de completitud de solicitudes puede evaluar las pruebas entrantes antes de que el caso llegue a la cola de un analista, identificando las brechas con la suficiente antelación para resolverlas en una etapa previa.
Para los equipos que deciden dónde desplegar agentes primero, esto sugiere una prueba relativamente específica:
- ¿Las pruebas están en gran medida disponibles?
- ¿Se puede definir con claridad el resultado requerido?
- ¿Una gran parte del esfuerzo actual se concentra en la investigación y la síntesis?
El modelo operativo importa tanto como la tarea
Identificar la tarea correcta es solo parte de la oportunidad. Las pruebas también sugieren que el desempeño de los agentes es muy sensible a cómo se diseña la investigación en sí.
El KYBench mostró que el desempeño puede variar según cómo se configure la investigación, incluida la estrategia de búsqueda y el diseño de los prompts. Eso convierte el diseño del flujo de trabajo, los requisitos de pruebas y las reglas de escalamiento en una parte central del desempeño del agente en la práctica.
La experiencia de Flora Zhang al frente del onboarding impulsado por IA en Brex plantea una idea similar desde producción. Su equipo mapeó la secuencia de verificaciones de onboarding, determinó dónde debían intervenir las personas o los agentes y construyó la arquitectura circundante en torno a esas decisiones. A medida que el sistema maduró, el trabajo pasó a centrarse en monitorear, ajustar y mantener el desempeño, en lugar de tratar el despliegue como un proyecto terminado.
Como lo expresa Flora:
“Igual de importante es todo el mantenimiento: lograr que el programa siga evolucionando por sí mismo… y entregar constantemente el resultado ideal en producción”.
Para los equipos de KYB, eso cambia el aspecto de un buen primer caso de uso. La pregunta pertinente no es simplemente si un agente puede llegar al resultado correcto. Los equipos exitosos evaluarán si utiliza pruebas adecuadas, se comporta de forma consistente en casos similares, escala la incertidumbre y sigue siendo lo bastante observable como para entender por qué un caso avanzó o se detuvo.
Esos controles son parte de la capacidad en sí.
Un camino creíble empieza con un problema acotado
Para los bancos que exploran el onboarding agéntico, un buen punto de partida es, por tanto, un problema cuyos contornos ya se entienden bien y cuyo resultado se puede evaluar con precisión.
Podría ser una investigación recurrente de noticias adversas, una discrepancia de beneficiario final u otra categoría de revisión en la que el equipo ya entienda los requisitos de pruebas y qué constituye una resolución satisfactoria.
Un problema acotado crea un mejor entorno de pruebas porque se pueden explicitar los límites: qué pruebas puede usar el agente, en qué condiciones puede avanzar un caso, qué debe desencadenar una investigación adicional y en qué punto la incertidumbre debe devolver el caso a un revisor.
Ejecutar el agente en paralelo con el proceso existente permite luego a los equipos comparar más que los resultados finales. Se pueden evaluar directamente la selección de pruebas, la consistencia, el comportamiento de escalamiento y la calidad de la siguiente acción.
Por lo tanto, un primer caso de uso exitoso aporta más que un flujo de trabajo automatizado. Da al equipo evidencia empírica sobre dónde es confiable la investigación agéntica en su propio entorno operativo, qué controles se requieren a su alrededor y cuál es el caso de uso adyacente que conviene abordar a continuación.
Con el tiempo, esas capacidades pueden empezar a conectarse. El resultado de una investigación de titularidad puede informar una decisión de screening posterior; un agente de completitud de solicitudes puede eliminar brechas evitables antes de la revisión posterior; un agente de investigación puede resolver un problema antes de que el caso llegue siquiera a la cola de un analista.
De esa progresión puede surgir un flujo de KYB más agéntico, en el que cada capacidad se gana su lugar primero mediante un caso de uso acotado y medible.
Para los equipos que intentan adelantarse a la creciente complejidad del KYB, la pregunta más duradera es dónde la abundancia de pruebas sigue generando un costo de resolución desproporcionado y si un agente puede reducir esa carga de forma confiable.